 資格道場
応用情報技術者「テクノロジ系コア」の一問一答

📖 応用情報技術者「テクノロジ系コア」の全217問と解説(一覧)
応用情報技術者のテクノロジ系コアに関する一問一答(全217問)の正解と解説の一覧です。上の一問一答で実際に解いてから、ここで復習・確認できます。
-
問1.2の補数表現で8ビットの符号付き整数の範囲は-127〜+128である。
正解:×(誤り)
解説:誤り。範囲は「-128〜+127」(負側-128, 正側+127、記述が逆)。
根拠: 第四回-02 コンピュータ上の数値の表現 (2) 負の数を含む整数の2進数による表現~2の補数表現(工学院大学 講義資料) 8ビットの整数の表現範囲の説明箇所
-
問2.IEEE754倍精度浮動小数点数は、符号1+指数8+仮数23ビットの計32ビットである。
正解:×(誤り)
解説:誤り。倍精度は「1+11+52=64ビット」(32ビットは単精度)。
根拠: f64: Wasm value type - MDN Web Docs Description / JavaScript data types and data structures - MDN Web Docs Number type
-
問3.丸め誤差とは、桁数の制限のため表現できない下位の桁を、切り捨てや四捨五入などで処理することにより生じる誤差である。
正解:○(正しい)
解説:正しい。丸め誤差は、計算機の記憶装置が有限の長さであるために生じる誤差で、切り上げや切り下げ、四捨五入など、ある桁数以上の数値を端数として省略することで生じる。例えば10進数の0.6は2進数で割り切れず、8ビットで表すと下位の桁が切り捨てられ、元の値との間に差が生じる。桁数の制限で下位の桁を省く誤差、と押さえておく。
根拠: 講談社 IT用語がわかる辞典「丸め誤差」(コトバンク) 丸め誤差の項 / 平凡社 世界大百科事典(旧版)「数値計算」(コトバンク) 【数値計算】の項(丸め誤差の言及) / 計算と誤差(立命館大学 理工学部) 丸め誤差の説明
-
問4.キャッシュメモリのライトスルーは、書込みをキャッシュのみで完了させる方式である。
正解:×(誤り)
解説:誤り。ライトスルーは「キャッシュと主記憶を同時更新」(キャッシュのみはライトバック)。
根拠: キャッシュメモリシステム(津田塾大学 講義資料) 書き込み操作/ライトスルー方式 / コンピュータハードウェアの構成(4)(京都産業大学 講義資料) キャッシュの書き込み方式(ストアスルー/ストアイン)
-
問5.パイプラインの制御ハザードは、データ依存により発生する。
正解:×(誤り)
解説:誤り。パイプラインで命令を適切なサイクルで実行できない状況をハザードという。命令どうしのデータの受け渡し(データ依存)の制約で生じるのはデータハザードで、制御ハザードではない。制御ハザードは分岐命令・ジャンプ命令によって生じる。分岐するかどうかが判明するまで、次にどの命令を実行すべきかが決まらないためである。判明するまで後続の命令を止める方法では分岐命令のたびにストール(待ち)が生じるので、分岐しないと見込んで先に進める方法なども使われる。もう一つの構造ハザードは、資源の不足で生じる。
根拠: IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類3:コンピュータ構成要素 1.プロセッサ(9)プロセッサの高速化技術 用語例「パイプラインハザード,データハザード,構造ハザード,制御ハザード」(PDF p.19・本文 p.15) / 計算機アーキテクチャ第二(O) 5.パイプライン処理(東京工業大学 吉瀬謙二、2009年後学期) PDF p.1 スライド「ハザード(hazard)」(命令を適切なサイクルで実行できない状況をハザードと呼ぶ。構造ハザード=資源不足により生じる/データ・ハザード=データの受け渡しの制約によって生じる/制御ハザード=分岐命令,ジャンプ命令によって生じる)、PDF p.3〜4 スライド「静的に採用できる制御ハザードの対処」(戦略1:分岐方向が判明するまで分岐命令の後続命令を止める。分岐命令の出現毎に1サイクルのストールが発生する)、PDF p.4 スライド「戦略2:predicted-not-taken方式」(すべての分岐命令をnot taken(不成立)として処理を進める。不成立ならペナルティなし)
-
問6.スーパースカラとVLIWは、いずれもコンパイラが命令スケジューリングを行う。
正解:×(誤り)
解説:誤り。スーパースカラ「ハードウェア」、VLIW「コンパイラ」(記述が逆)。
-
問7.Amdahlの法則で並列化可能50%の場合、無限並列化で性能は4倍が上限となる。
正解:×(誤り)
解説:誤り。アムダールの法則では、高速化率E=1/((1−r)+r/n)(r:処理のうち並列化できる部分の割合、n:プロセッサの台数)。nを限りなく増やすとr/nは0に近づくので、Eは1/(1−r)より大きくならない。r=0.5なら1/(1−0.5)=2倍が上限で、4倍にはならない。並列化できない残り50%の処理時間はプロセッサを増やしても縮まないため、全体の処理時間は元の半分より短くならない。
根拠: IPA 令和7年度春期 応用情報技術者試験 午前 問題 問11(高速化率 E=1/(1−r+r/n)、n:プロセッサの台数、r:並列化が可能な部分の割合)(問題冊子 p.8) / IPA 令和7年度春期 応用情報技術者試験 解答例(午前) 問11 正解 エ(6台) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類3:コンピュータ構成要素 1.プロセッサ(11)マルチプロセッサシステム 用語例「アムダールの法則」(PDF p.20・本文 p.16)
-
問8.GPUはSIMD型の並列演算に適しており、ディープラーニングや画像処理で利用される。
正解:○(正しい)
解説:正しい。SIMD(Single Instruction, Multiple Data)は、1つの命令で複数の演算要素を動かし、多くのデータに同じ演算を同時に行う並列処理の方式である。NVIDIAのGPUは、32本のスレッドをひとまとまり(ワープ)にして共通の命令を1つずつ実行するSIMTという方式をとり、1つの命令が複数の演算要素を制御する点でSIMDに近い。このため、画像処理や、単純だが大量の計算を繰り返すディープラーニングの学習のように、同じ演算を大量のデータに行う処理に向いている。
根拠: NVIDIA CUDA Programming Guide(13.1)3.2.2.1 SIMT Execution Model 3.2.2.1 SIMT Execution Model(32本のスレッドのまとまり=warp が共通の命令を1つずつ実行する。The SIMT architecture is akin to SIMD … a single instruction controls multiple processing elements) / GPUサーバー(ジーピーユーサーバー)とは? 意味や使い方(デジタル大辞泉) GPUサーバーの項(高速で並列処理を行い、高度な画像処理や、単純だが大量の計算を繰り返し行う必要があるディープラーニングなどの学習に向く)
-
問9.DMAは、CPUを介さずに周辺装置と主記憶の間で直接データ転送を行う方式である。
正解:○(正しい)
解説:正しい。DMA(Direct Memory Access)は、主記憶装置と周辺装置の間で、処理装置によるデータの処理を必要とせずに、データを直接移動させる技法である(JIS X 0011)。
-
問10.割込みのうち、ゼロ除算や不正命令により発生するのは外部割込みである。
正解:×(誤り)
解説:誤り。ゼロ除算や不正命令は内部割込み(例外)です。外部割込みは入出力装置・タイマ等が原因です。
根拠: オペレーティングシステム #2(名古屋工業大学 講義資料) 割込みの種類:内部割込み(プログラムチェック(例外)割込み)
-
問11.プロセスとスレッドの違いとして、同一プロセス内のスレッドはアドレス空間を共有する。
正解:○(正しい)
解説:正しい。同じプロセスの中のスレッドは、そのプロセスのアドレス空間(プログラムのコード、静的変数、ヒープ領域など)を共有するので、どのスレッドからも同じ変数を読み書きできる。一方、スレッドID、スケジューリングの優先度、レジスタの内容(プログラムカウンタなど)、スタックはスレッドごとに持つ。プロセスはそれぞれ別のアドレス空間を持つ。共有するのはメモリ、スレッドごとに持つのは実行の流れ(レジスタとスタック)、と押さえる。
根拠: POSIX.1-2024 (The Open Group Base Specifications Issue 8), XBD 3. Definitions 3.5 Address Space(プロセス又はそのスレッドが参照できるメモリ位置)、3.189 Live Process、3.190 Live Thread(スレッドごとにスレッドID・スケジューリング優先度などを持ち、アドレスを求められるものは同じプロセスの全スレッドからアクセスできる) / About Processes and Threads - Win32 apps (Microsoft Learn) 冒頭の段落(All threads of a process share its virtual address space、スレッドごとにスケジューリング優先度・スレッドID・スレッドコンテキスト=マシンレジスタ・カーネルスタック・ユーザースタックを持つ)
-
問12.セマフォは、単一プロセス内のメモリ管理機構である。
正解:×(誤り)
解説:誤り。セマフォは「複数プロセス間の同期機構」(共有資源アクセス制御)。
根拠: The Open Group Base Specifications (IEEE Std 1003.1) – sem_open() sem_open DESCRIPTION
-
問13.デッドロックが発生するには、相互排除・保有と待機・横取り不可・循環待機の4条件がすべて成り立つ必要がある。
正解:○(正しい)
解説:正しい。4条件はデッドロック発生の必要条件で、相互排除(資源を同時に1つのプロセスしか使えない)、保有と待機(資源を持ったまま別の資源を待つ)、横取り不可(使用中の資源を強制的に取り上げられない)、循環待機(待ちの関係が輪になる)がすべて成り立たなければ発生しない。どれか1つを成り立たなくすればデッドロックを防げる(防止)。これに対し、必要な資源の最大量を前もって申告させ、危険な状態につながる割当てを断る銀行家アルゴリズムの方法は回避と呼ぶ。
根拠: Operating Systems Course Notes: Deadlocks(University of Illinois Chicago, John T. Bell) 7.2.1 Necessary Conditions(four conditions that are necessary to achieve deadlock)、7.4 Deadlock Prevention(preventing at least one of the four required conditions)、7.5.3 Banker's Algorithm / UC Riverside CS 153 Design of Operating Systems (Fall 2020) Lecture 14: Deadlock(講義スライド) p.6 Conditions for Deadlock(4条件)、p.13 Deadlock Prevention(必要条件の少なくとも1つが起きないようにする)、p.15〜16 Deadlock Avoidance・Banker's Algorithm(最大要求量を前もって申告・危険な状態につながる要求を拒否)
-
問14.ページ置換アルゴリズムのLRUは、次回参照までの時間が最も長いページを追い出す理想アルゴリズムである。
正解:×(誤り)
解説:誤り。それはOPT(最適)アルゴリズムです。LRUは「最も長く参照されていない」ページを追い出します。
-
問15.外部断片化と内部断片化は同じ意味である。
正解:×(誤り)
解説:誤り。外部断片化は「未使用領域分散」、内部断片化は「割当てブロック内の余り」(別概念)。
根拠: Ichiro Satoh 記憶管理(OS講義資料 OS2001-memory) 「断片化」「可変区画方式」のスライド
-
問16.i-nodeは、ファイルの本体データを格納する領域である。
正解:×(誤り)
解説:誤り。i-nodeは「メタデータ(パーミッション・所有者・ブロック位置等)」(本体データ別領域)。
根拠: The Second Extended Filesystem — The Linux Kernel documentation Specification > Inodes
-
問17.RAID6は1台のディスク故障までしか耐えられない。
正解:×(誤り)
解説:誤り。RAID6は「2台同時故障に耐えられる」(2種類のパリティ)。1台はRAID5。
根拠: RAID(レイド)とは? 意味や使い方 - コトバンク(日本大百科全書(ニッポニカ)「RAID」) (6)RAID6 の項
-
問18.M/M/1モデルでρ=0.8のとき、平均待ち人数は0.8人である。
正解:×(誤り)
解説:誤り。M/M/1の平均待ち人数Lq=ρ²/(1-ρ)=0.64/0.2=3.2人であり、0.8人ではない。なお平均系内人数L=ρ/(1-ρ)=4.0人だが、これは待ち人数Lqとは別概念(L=Lq+ρ)。
根拠: 田村仁研究室(日本工業大学創造システム工学科) コンピュータリテラシー2 第4回「待ち行列のシミュレーション」 「待ち行列のモデル」節、M/M/1モデルの解析解の箇条書き
-
問19.稼働率0.9の装置2台を直列に接続すると全体の稼働率は0.99、並列に接続すると0.81となる。
正解:×(誤り)
解説:誤り。直列に接続すると2台とも動いていなければ全体が動かないので、全体の稼働率は各装置の稼働率の積で 0.9×0.9=0.81。並列に接続するとどちらか1台が動いていればよいので、2台とも止まっている確率(1-0.9)×(1-0.9)=0.01 を1から引いて 1-0.01=0.99。問題文は直列と並列の値が逆になっている。並列にすると稼働率は1台のときより上がり、直列にすると下がる、と押さえる。
根拠: workbook and errata(JAIST 講義 i450 ワークブック補足) 補足説明「直列システムと並列システムの稼働率」(直列 A=A1*A2*…*An、並列 A=1-(1-A1)*(1-A2)*…*(1-An)) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 PDF p.26 ② 信頼性指標と信頼性計算(並列システム,直列システムの稼働率の計算方法を理解する)
-
問20.コンテナ型仮想化はハイパーバイザ型より起動が遅くリソース消費も大きい。
正解:×(誤り)
解説:誤り。ハイパーバイザ型は仮想マシンごとにカーネルを含む完全なゲストOSを動かすため、CPU・メモリ・ストレージを多く使い、起動にも時間がかかりやすい。コンテナ型はホストOSのカーネルを共有し、アプリと必要な部品だけを持つので軽く、起動が速く資源の消費も少ない。本文は両者の関係が逆になっている。
根拠: Containers vs. virtual machines(Microsoft Learn) Virtual machine architecture/Containers vs. virtual machines の表「Operating system」行(VM は完全なOSを動かし more system resources、コンテナは fewer system resources) / What is a Container?(Docker) Comparing Containers and Virtual Machines(Containers take up less space than VMs/VMs can also be slow to boot) / NIST Special Publication 800-190 Application Container Security Guide 2.2 Containers and the Host Operating System(VM は完全なゲストOSを含み、コンテナはホストOSのカーネルを共有)
-
問21.ライブマイグレーションは、仮想マシンを稼働させたまま別の物理サーバへ移動する技術である。
正解:○(正しい)
解説:正しい。ライブマイグレーションは、稼働中の仮想マシンを止めずに、利用者が気づくほどの停止時間なしで別の物理サーバ(ホスト)へ移す技術。仮想マシンが特定の物理サーバに縛られなくなるので、更新や撤去の前にそのサーバ上の仮想マシンを他へ移して保守したり、負荷の高いサーバから仮想マシンを移して負荷を分散したりできる。
根拠: Use live migration without Failover Clustering to move a virtual machine (Microsoft Learn, Windows Server Hyper-V) 冒頭の説明(A live migration moves running virtual machines between Hyper-V hosts without any noticeable downtime) / Live Migration Overview (Microsoft Learn, Windows Server Hyper-V) 冒頭の説明(稼働中の VM を perceived downtime なしに別ホストへ移す/更新・撤去前にホストから VM を移せる) / Containers vs. virtual machines(Microsoft Learn) 表の「Load balancing」行(Virtual machine load balancing moves running VMs to other servers in a failover cluster) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類4:システム構成要素 1.システムの構成(2)システム構成 用語例「マイグレーション(ライブマイグレーションほか)」(PDF p.24・本文 p.20)
-
問22.グリッドコンピューティングとクラスタコンピューティングは同義で、地理的に分散した計算資源は扱わない。
正解:×(誤り)
解説:誤り。グリッドは地理的・組織的に分散した資源を統合、クラスタは同一拠点・同構成の資源結合で性質が異なります。
-
問23.5Gの特徴は、低速・高遅延・少数同時接続の3つである。
正解:×(誤り)
解説:誤り。5Gは「高速大容量・超低遅延・多数同時接続」(記述が逆、特徴3要素)。
-
問24.エッジコンピューティングは、データ発生源近くで処理を行うことで遅延低減や帯域負荷軽減を図るアーキテクチャである。
正解:○(正しい)
解説:正しい。エッジコンピューティングは、データの処理や保存を遠くに集中したデータセンター(クラウド)ではなく、データが発生・利用される場所の近く(工場の中、携帯電話の基地局、機器そのものなど)で行う分散処理の考え方。クラウドまでの往復が無くなるので応答の遅れ(遅延)が小さくなり、データを全部送らずに済むので回線の帯域の消費も抑えられる。クラウドを置き換えるのではなく、組み合わせて使う。
根拠: Edge computing | IEEE Technology Navigator What Is Edge Computing?(reduces latency, conserves network bandwidth)/Relationship to Cloud Computing(complements rather than replaces cloud computing) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類4:システム構成要素 1.システムの構成(2)システム構成 用語例「エッジコンピューティング」(PDF p.24・本文 p.20)
-
問25.量子ビットは、0または1のみを表現できる従来のビットと同じである。
正解:×(誤り)
解説:誤り。量子ビットは「0と1の重ね合わせ状態」を表現可能(従来ビットと異なる)。
-
問26.プログラム実行時のスタック領域は、関数呼出しのリターンアドレスやローカル変数を格納する。
正解:○(正しい)
解説:スタックフレームには引数・リターンアドレス・ローカル変数が含まれます。
根拠: x64 stack usage (Microsoft Learn, MSVC) Stack allocation 節、および関数 A が B を呼ぶスタックレイアウトの例の説明
-
問27.ガーベジコレクションは、プログラムが手動で呼び出さないとメモリ解放しない機能である。
正解:×(誤り)
解説:誤り。GCは「自動的にメモリ解放」(手動ではない)。
根拠: Java Platform, Standard Edition HotSpot Virtual Machine Garbage Collection Tuning Guide, Release 12 – Introduction What Is a Garbage Collector? / Tuning Java Virtual Machines (JVMs) (Oracle WebLogic Server 8.1 Performance and Tuning) JVM Heap Size and Garbage Collection
-
問28.GoFのデザインパターンのFactory Methodパターンは、インスタンス生成をサブクラスに委譲する設計パターンである。
正解:○(正しい)
解説:正しい。Factory Methodパターンでは、スーパークラスにコンポーネントが実行時に必要とするオブジェクトを生成するメソッドを用意し、どのクラスをどのようにインスタンス化するかの決定をサブクラスに委ねる。GoF(Gamma、Helm、Johnson、Vlissides)の『Design Patterns』で示されたパターンの一つで、インスタンス化の過程を抽象化する生成に関するパターン(Creational pattern)に分類される。
-
問29.MVCアーキテクチャでは、View層がビジネスロジックを担当する。
正解:×(誤り)
解説:誤り。ビジネスロジックはModel層の役割。Viewは表示、Controllerは入力処理と両者の橋渡しです。
根拠: MVC - Glossary - MDN Web Docs MVC の3要素の説明(Model / View / Controller) / ASP.NET MVC Overview (Microsoft Learn) MVC pattern の各ロジックの置き場所(UI logic / Input logic / Business logic)
-
問30.マイクロサービスアーキテクチャは、機能を独立したサービスに分割してAPIで連携させる設計思想である。
正解:○(正しい)
解説:独立デプロイ・スケーリング・言語選択の自由度が高く、DevOpsと相性が良い構成です。
-
問31.RESTful APIは、HTTPメソッド(GET/POST/PUT/DELETE)でリソースに対する操作を表現するAPI設計スタイルである。
正解:○(正しい)
解説:正しい。HTTPの上に作るRESTful APIでは、GET・POST・PUT・DELETEなどの標準のHTTPメソッドで、リソースに対する操作を行う。URIにはリソースを名詞で表すのがよいとされる。動作の意味はHTTPメソッドが表すためである。もう一つの特徴はステートレスで、各リクエストは互いに独立している。
-
問32.テスト駆動開発(TDD)では、実装コードを先に書いてから対応するテストを書く。
正解:×(誤り)
解説:誤り。TDDは「失敗するテストを先に書き、それを通す実装を書く」サイクル(Red-Green-Refactor)です。
根拠: bliki: Test Driven Development (Martin Fowler) 本文冒頭の3ステップ、および「Writing the test first」の段落
-
問33.CI/CDのうち、CIはソースコードを頻繁に統合してテストする仕組み、CDは継続的デリバリーまたはデプロイを指す。
正解:○(正しい)
解説:正しい。CI(継続的インテグレーション)は、開発者が変更したコードを頻繁に共有のリポジトリへ統合し、そのたびに自動でビルドとテストを行う仕組み。CDは継続的デリバリーと継続的デプロイのどちらかを指す。継続的デリバリーは、テスト済みのコードをいつでも本番に出せる状態まで自動で進め、本番への反映は手動(ボタン操作など)で行う。継続的デプロイは、本番への反映まで自動で行う点が違う。
根拠: NIST SP 800-204C, Implementation of DevSecOps for a Microservices-based Application with Service Mesh Abstract(CI/CD=continuous integration, continuous delivery, and continuous deployment)/3.3.1 Concept of Pipelines and the CI/CD Pipeline(PDF p.22〜23:CI の定義、continuous delivery の本番反映は manual、continuous deployment は releases happen automatically) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類13:ソフトウェア開発管理技術 1.開発プロセス・手法(1)③ DevOps 用語例「継続的インテグレーション(CI),継続的デリバリー(CD),継続的デプロイ」(PDF p.79・本文 p.75)
-
問34.IaCは、インフラ構成を手動で管理する従来手法である。
正解:×(誤り)
解説:誤り。IaCは「コードでインフラ定義・管理」(自動化)、手動は従来型。
-
問35.バイアス・バリアンスのトレードオフで、過剰適合はバイアスが高い状態である。
正解:×(誤り)
解説:誤り。過剰適合は「バリアンスが高い」状態(学習データに敏感、新規データで誤差大)。
根拠: What is Bias-Variance Tradeoff? (IBM Think) Tradeoff illustrated(Bias / Variance の項)
-
問36.キャッシュメモリのヒット率が0.95、キャッシュアクセスが5ns、主記憶アクセスが80nsのときの平均アクセス時間[ns]はいくらか。ここで、キャッシュに無いデータは主記憶から読み出し、その時間は主記憶のアクセス時間だけとする。
- ア.5.0
- イ.9.0
- ウ.8.75
- エ.80.0
正解:ウ.8.75
解説:正解は8.75。平均アクセス時間は、各記憶階層へのアクセス時間に、その階層にデータを取りに行く確率をかけたものの総和として求める。キャッシュから読む確率が0.95、主記憶から読む確率が1−0.95=0.05なので、0.95×5+0.05×80=4.75+4.0=8.75[ns]となる。キャッシュに無いときにキャッシュを調べる5nsも足して0.95×5+0.05×(5+80)=9.0とするのは、本問の条件と異なる。5.0はキャッシュだけ、80.0は主記憶だけのアクセス時間である。
根拠: 名古屋大学 嶌田研究室 講義資料「3.4 記憶階層のアーキテクチャ」(chap03text2.pdf) p.18-19「(2) メモリの平均アクセス時間」平均アクセス時間の例1
-
問37.稼働率0.9のシステム3台を多数決(2/3)で構成したときの全体稼働率として最も近い値はどれか。
- ア.0.81
- イ.0.90
- ウ.0.99
- エ.0.97
正解:エ.0.97
解説:2/3多数決は、3台のうち2台以上が動いていれば全体が動く構成で、全体の稼働率は「ちょうど2台が動く確率」と「3台とも動く確率」の和になる。ちょうど2台が動くのは、止まる1台の選び方が3通りあり、それぞれ 0.9×0.9×0.1=0.081 なので 3×0.081=0.243。3台とも動くのは 0.9×0.9×0.9=0.729。合計 0.243+0.729=0.972 で、最も近いのは0.97。0.81は2台を直列にしたとき(0.9×0.9)、0.90は1台だけのとき、0.99は2台を並列にしたとき(1-0.1×0.1)の値で、多数決構成の値ではない。
根拠: JIS Z 8115:2019 ディペンダビリティ(総合信頼性)用語 192-10 信頼性設計「m-out-of-n冗長」(192-10-12:全体でn個のアイテム中で少なくともm個が機能していなければならない冗長)、「三重多数決冗長」(注記:三つの常用冗長モジュールのうち,少なくとも二つ以上が動作していること)、「多数決冗長」 / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 PDF p.26 ② 信頼性指標と信頼性計算(並列システム,直列システムの稼働率の計算方法を理解する)
-
問38.並列処理のAmdahl則で、処理の80%が並列化可能・20%が逐次のとき、プロセッサ数を無限に増やしたときの最大高速化倍率はどれか。
- ア.5倍
- イ.3倍
- ウ.4倍
- エ.2倍
正解:ア.5倍
解説:アムダールの法則では、高速化率E=1/((1−r)+r/n)(r:並列化できる部分の割合、n:プロセッサの台数)。1−rは並列化できない逐次部分の時間、r/nは並列部分をn台で分けた後の時間を表す。nを限りなく増やすとr/nは0に近づき、上限は逐次部分の逆数1/(1−r)になる。r=0.8なら1/(1−0.8)=1/0.2=5倍。3倍は6台、4倍は16台のときの値で、2倍はさらに少ない台数で届く。どれも台数を増やせばまだ伸びるので上限ではない。
根拠: IPA 令和7年度春期 応用情報技術者試験 午前 問題 問11(高速化率 E=1/(1−r+r/n)、n:プロセッサの台数、r:並列化が可能な部分の割合)(問題冊子 p.8) / IPA 令和7年度春期 応用情報技術者試験 解答例(午前) 問11 正解 エ(6台) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類3:コンピュータ構成要素 1.プロセッサ(11)マルチプロセッサシステム 用語例「アムダールの法則」(PDF p.20・本文 p.16) / 3.5.1 アムダールの法則 (Sun Studio 12: C ユーザーズガイド) 3.5.1 アムダールの法則(式 1/S = F + (1-F)/P)
-
問39.メモリインタリーブの主な目的はどれか。
- ア.主記憶容量の仮想的な拡張
- イ.主記憶アクセスの高速化
- ウ.主記憶のビット誤りの訂正
- エ.キャッシュのヒット率の向上
正解:イ.主記憶アクセスの高速化
解説:メモリインタリーブは、主記憶を独立して動く複数のバンクに分け、連続するアドレスを順に別のバンクへ割り付ける方式である。連続したアクセスを別々のバンクで重ねて進められるので、主記憶の実効的なサイクルタイムが短くなり、時間あたりの転送量が上がる。目的は主記憶アクセスの高速化である。主記憶容量を仮想的に広げるのはハードディスクなどを使う仮想記憶、ビット誤りの訂正は誤り訂正符号を付けるECCメモリーの働きで、キャッシュのヒット率はキャッシュに目的のデータがある割合を表す。どれもアドレスの割り付け方を工夫するインタリーブの目的ではない。
根拠: IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類3:コンピュータ構成要素 2.メモリ(4)アクセス方式「主記憶装置を高速化するメモリインターリーブ方式を理解する。」用語例「バンク」、(5)メモリの容量と性能「キャッシュメモリのヒット率」(PDF p.21・本文 p.17) / 情報処理学会 コンピュータ博物館「MELCOM 7500/7700」 主記憶の説明(連続して主記憶をアクセスするときに順次異なったメモリ・モジュールをアクセスできるようアドレスを割り付けるインタリーブ方式で、連続したアクセスをオーバーラップさせ実行アクセス時間を短縮。サイクルタイム0.85μs、インタリーブ時は実効0.56μs) / 名古屋大学 講義資料「計算機システム概論」第3章 (3)メモリインタリーブ(主記憶装置をバンクに分け、バンクごとに並列にアクセスできるようにする。アクセス時間は短縮できないが、1秒あたりのデータ転送量はバンクの数倍だけ向上) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) Chapter 21 Beyond Physical Memory: Mechanisms p.1(物理メモリより大きな仮想アドレス空間を、容量の大きい遅い装置=ハードディスクを使って提供する) / デジタル大辞泉・IT用語がわかる辞典「ECCメモリー」(コトバンク) 用語解説(データに誤り訂正符号を付加し、誤りを自動的に検出して訂正する機能をもつメモリー)
-
問40.M/M/1待ち行列で利用率ρ=0.5のときの平均系内人数L(待ち人数+サービス中)はいくつか。
- ア.0.25
- イ.0.5
- ウ.1.0
- エ.2.0
正解:ウ.1.0
解説:M/M/1は窓口が1つの待ち行列モデル。利用率ρは平均到着率λを平均サービス率μで割った値(ρ=λ/μ)で、窓口がふさがっている時間の割合を表す。系内(待ち+サービス中)の平均人数はL=ρ/(1−ρ)なので、0.5/(1−0.5)=1.0人。0.5は待っている人だけの平均人数Lq=ρ²/(1−ρ)、0.25はρ²、2.0は1/(1−ρ)で平均応答時間が平均サービス時間の何倍かを表す値で、どれも系内の平均人数ではない。
根拠: MIT OpenCourseWare 2.854 Introduction to Manufacturing Systems (Fall 2016)「M/M/1 Queue」 p.1(Ls=λ/(μ−λ)=ρ/(1−ρ)、ρ=λ/μ、Ws=1/(μ−λ))/p.2(Lq=λ²/(μ(μ−λ))、server is busy with frequency ρ) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類1:基礎理論 2.応用数学(6)待ち行列理論「M/M/1 モデルにおける計算」用語例「平均到着率,平均サービス率」(PDF p.8・本文 p.4)
-
問41.OSで、複数のプロセスが1つの資源を同時に使わないようにする排他制御の基本的な仕組みはどれか。
- ア.タイマ割込み
- イ.ページング
- ウ.ラウンドロビン
- エ.セマフォ
正解:エ.セマフォ
解説:セマフォは、資源の空きの数を表す変数(セマフォ変数)で排他制御を行う仕組み。資源を使う前に値を1減らし、使い終わったら1増やし、空きが0のときは待ち状態になる。同時に使える数を初期値までに制限できるので、初期値を1にすると一度に1つのプロセスしか資源を使えず、同時に使うことを防げる。タイマ割込みは一定時間ごとに発生してプロセスの切替えに使う割込み、ページングは仮想記憶の管理方式、ラウンドロビンは順番に短いCPU時間を割り当てるスケジューリング方式で、どれも資源の同時使用を防ぐ仕組みではない。
根拠: オペレーティングシステム #5(名古屋工業大学 松尾啓志 講義資料) 並行プロセス:セマフォ p.2 排他制御(クリティカルセクションに同時に複数プロセスが入らないようにする制御)、p.8 セマフォ変数(リソースの空きを表現する変数)、p.13 まとめ:セマフォ(P命令=空きリソース数をデクリメント・空きがない場合は待ち状態/V命令=インクリメント)、p.17 排他制御(S = 1 で P(S)・クリティカルセクション・V(S)) / Semaphore Objects - Win32 apps (Microsoft Learn) 冒頭の説明(count を wait で1減らし release で1増やす、0 なら待つ、共有資源を使うスレッドの数を指定の最大数までに制限する) / オペレーティングシステム #3(名古屋工業大学 松尾啓志 講義資料) CPUの仮想化:スケジューリング p.28 RR(待ち行列から選択されたプロセスに微少なCPU利用時間(クオンタム)を割り当て) / オペレーティングシステム #2(名古屋工業大学 松尾啓志 講義資料) CPUの仮想化:プロセス p.14 プロセスの切り替え(インターバルタイマーが定期的に割込みを発生)、p.26 外部割込み:タイマ割込み / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類5:ソフトウェア 1.オペレーティングシステム(4)タスク管理 ② 多重プログラミングとスケジューリング「同期制御・排他制御の必要性,実現方法」用語例「ラウンドロビン」「排他制御」(PDF p.27)/(7)記憶管理 ② 仮想記憶管理「ページング方式」(PDF p.28)
-
問42.デッドロックの発生を回避する手法として、資源要求時に将来も含めた安全性を判定する手法はどれか。
- ア.銀行家アルゴリズム
- イ.ロック順序付け
- ウ.待ちグラフの定期的な閉路検査
- エ.資源獲得のタイムアウト
正解:ア.銀行家アルゴリズム
解説:銀行家アルゴリズム(バンカーズアルゴリズム)は、各プロセスが使う資源の最大量を前もって申告させ、資源の割当て要求のたびに、認めた後も安全状態(空いている資源と、終わったプロセスが返す資源で、全プロセスを順に最後まで動かせる順序がある状態)が保てるかを調べ、保てなければ要求を待たせる。この考え方を回避と呼ぶ。ロック順序付けは資源に番号を付け、小さい番号から順にしか確保させないことで循環待機を崩す防止の手法である。待ちグラフの定期的な閉路検査と資源獲得のタイムアウトは、起きてしまったデッドロックを見つけてプロセスを止めるなどで対処する検出の手法である。
根拠: CS 4410 Lecture 9: Deadlock(Cornell University, Summer 2017 講義ノート) Deadlock prevention(Breaking hold-and-wait/Breaking circular wait: lock ordering=資源に番号を付け小さい番号から確保)、Deadlock detection(資源獲得に時間制限を設ける・resource allocation graph の閉路を調べる)、Deadlock avoidance: Banker's algorithm(各プロセスの最大要求を把握し、要求を認めても safe state が保てなければ待たせる。safe state の定義) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) Chapter 32 Common Concurrency Problems Deadlock Bugs の節:Prevention の Circular Wait(p.7、ロック獲得の順序を決める)・Hold-and-wait(p.8、ロックをまとめて取得)、Avoidance via Scheduling(p.12〜13、Banker's Algorithm に言及)、Detect and Recover(p.13) / Operating System Course Notes Chapter 7 Deadlocks(University of Illinois Chicago, J. Bell) 7.5.3 Banker's Algorithm(開始時に最大要求を申告させ、要求のたびに認めても safe state か調べ、そうでなければ待たせる)、7.6.1 Single Instance of Each Resource Type(wait-for graph を保持し、定期的に閉路を探して検出する)
-
問43.プロセスがよく参照するページの集まり(ワーキングセット)に対して主記憶のページ枠が不足し、ページの置換えが頻発して処理能力が急激に低下する現象はどれか。
- ア.ページフォールト
- イ.スラッシング
- ウ.デッドロック
- エ.フラグメンテーション
正解:イ.スラッシング
解説:ページング方式の仮想記憶では、ワーキングセットが主記憶のページ枠に収まらないと、追い出したページがすぐまた必要になり、ページ置換えが頻発する。補助記憶との入替えに時間を取られて処理能力が急激に落ちる現象がスラッシング。ページフォールトは参照したページが主記憶に無いときに起き、OSがそのページを読み込むきっかけになるもので、仮想記憶では普段から起きる。それが頻発した結果がスラッシングである。デッドロックは互いが持つ資源の解放を待って進めなくなる状態、フラグメンテーションは空き領域が細切れになり使えなくなる現象で、どちらもページ枠の不足で起きる現象ではない。
根拠: IPA 令和6年度秋期 応用情報技術者試験 午前 問題 問17(ページング方式の仮想記憶において,ページ置換えの発生頻度が高くなり,システムの処理能力が急激に低下する現象。選択肢:スラッシング/スワップアウト/フラグメンテーション/ページフォールト)(問題冊子 p.10) / IPA 令和6年度秋期 応用情報技術者試験 解答例(午前) 問17 正解 ア(スラッシング) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類5:ソフトウェア 1.オペレーティングシステム(7)記憶管理 ② 仮想記憶管理 用語例「スラッシング」「ページフォールト」「ワーキングセット」/① 実記憶管理「フラグメンテーションとその対策」(PDF p.28・本文 p.24) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) 22 Beyond Physical Memory: Policies 22.12 Thrashing(memory demands exceed physical memory → constantly paging=thrashing、working sets=the pages that they are using actively)(PDF p.14) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) 21 Beyond Physical Memory: Mechanisms 21.3 The Page Fault/21.5 Page Fault Control Flow(ページが主記憶に無いとき OS の page-fault handler がディスクから読み込む)(PDF p.4〜8) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) 32 Common Concurrency Problems 32.3 Deadlock Bugs(互いが持つロックの解放を待つ状態)(PDF p.5〜7) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) 17 Free-Space Management 冒頭(external fragmentation:空き領域が細切れになり、合計は足りても連続した領域を確保できない)(PDF p.1)
-
問44.ブロックサイズ4KB、容量8TBのディスクで、ブロック番号を32ビットで表す(1TB=2⁴⁰バイトとする)。32ビットで全ブロックの番号を表せるかを、ブロック数を求めて判断した。計算と結論がともに正しいものはどれか。
- ア.ブロック数は2⁴³÷2¹⁰=2³³で、2³²個の番号に収まらないので不足
- イ.ブロック数は2⁴³のままで、2³²個の番号に収まらないので不足
- ウ.ブロック数は2⁴³÷2¹²=2³¹で、2³²個の番号に収まるので十分
- エ.ブロック数は2⁴⁰÷2¹⁰=2³⁰で、2³²個の番号に収まるので十分
正解:ウ.ブロック数は2⁴³÷2¹²=2³¹で、2³²個の番号に収まるので十分
解説:ブロック番号は1ブロックに1つ必要なので、ブロック数が32ビットで表せる番号の数(2³²個、約43億)以下なら足りる。8TB=2³×2⁴⁰=2⁴³バイト、4KB=2²×2¹⁰=2¹²バイトなので、ブロック数は2⁴³÷2¹²=2³¹(約21億)で、2³²個に収まり十分。2⁴³をそのまま使うのはバイト数とブロック数の取り違え、2⁴³÷2¹⁰は4KBの「4」を落とした誤りで、どちらも不足という結論になる。2⁴⁰÷2¹⁰は8TBの「8」と4KBの「4」を落とし、単位のTとKだけで割った誤りで、結論は十分でも計算が違う。なお8TBを8×10¹²バイトとしても約19.5億ブロックで、結論は変わらない。
根拠: テラバイト(デジタル大辞泉/IT用語がわかる辞典)- コトバンク 「テラバイト」の用語解説(1TB=2^40バイト、または10^12バイト) / IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類5:ソフトウェア 3.ファイルシステム(3)ファイル編成とアクセス手法 用語例「ブロック,ブロックサイズ」(PDF p.31・本文 p.27)
-
問45.SSDで書込み回数の偏りを防ぐ制御機構はどれか。
- ア.トリム
- イ.プリフェッチ
- ウ.ガーベジコレクション
- エ.ウェアレベリング
正解:エ.ウェアレベリング
解説:ウェアレベリングは、SSDのコントローラが書込み先の物理的な位置を分散させ、ブロックごとの書込み・消去の回数を平均化する仕組みである。フラッシュメモリは同じブロックの消去と書込みを繰り返すとそこから先に使えなくなるので、偏りを防いで装置全体の寿命を延ばす。トリムはOSが削除して不要になった領域をSSDに知らせる命令、ガーベジコレクションは古いデータが残るブロックから有効なデータだけを移し、ブロックを消去して空きを作る処理、プリフェッチは使いそうなデータを前もって読み込む先読みで、いずれも書込み回数の平均化を目的とした仕組みではない。
根拠: デジタル大辞泉「ウェアレベリング」(コトバンク) 用語解説(物理的な書き込み位置を分散させ、書き込みの頻度を平均化する) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) Chapter 44 Flash-based SSDs p.7(消去・書込みを繰り返したブロックは使えなくなる・wear leveling)、44.8 Garbage Collection(p.10〜11:有効なページを移してブロックを消去し空きを作る)、Aside: A New Storage API Known As Trim(p.12:削除したブロックをデバイスに知らせる)、44.10 Wear Leveling(p.17) / プログレッシブ英和中辞典(第5版)「prefetch」(コトバンク) 《コンピュ》〈データを〉先読みする/[名] プリフェッチ,先読み
-
問46.IEEE754単精度浮動小数点の指数部(バイアス付き)のバイアス値はいくつか。
- ア.127
- イ.128
- ウ.1023
- エ.1024
正解:ア.127
解説:IEEE 754の単精度は符号1ビット・指数部8ビット・仮数部23ビットで、指数部は符号を付けずに格納するため、実際の指数にバイアス127を足した値(格納値=実際の指数+127)を入れる。たとえば格納値150なら実際の指数は150−127=23である。格納値は0〜255で、全ビット0と全ビット1は特別な数に使う。127は2の7乗−1、倍精度は指数部11ビットでバイアスは1023(2の10乗−1)。選択肢の1023は倍精度のバイアス、128と1024はそれぞれ2の7乗・2の10乗そのもので、バイアスはそこから1を引いた値になる。
-
問47.符号付き8ビット2の補数で、-1を表すビット列はどれか。
- ア.10000001
- イ.11111111
- ウ.11111110
- エ.00000001
正解:イ.11111111
解説:2の補数表現では、負の数−xを「x−1の各ビットを反転したビット列」で表す。−1なら1−1=0(00000000)を反転して11111111になる。+1(00000001)の各ビットを反転した11111110に1を足しても同じ結果になる。8ビットでは先頭が1のビット列が負の数で、−1から−128(10000000)までを表す。ほかの選択肢を同じ方法で読むと、10000001は反転すると01111110(126)なので−127、11111110は反転すると00000001(1)なので−2、00000001は+1である。
-
問48.パイプライン処理における制御ハザードを低減する手法として最も直接的なものはどれか。
- ア.メモリインタリーブ
- イ.キャッシュ階層化
- ウ.分岐予測
- エ.DMA
正解:ウ.分岐予測
解説:正解は分岐予測。制御ハザードは、分岐命令やジャンプ命令によって生じるハザードである。分岐の方向が判明するまで後続の命令を止めるとストールが生じるので、分岐の結果を予測して処理を進める方法がとられる。例えば、すべての分岐を不成立として進める predicted-not-taken 方式では、予測が当たればペナルティは生じない。メモリインタリーブ、キャッシュの階層化、DMA は記憶装置や入出力の性能を上げる技術で、制御ハザードへの直接の対策ではない。
根拠: 計算機アーキテクチャ第二(O) 5.パイプライン処理(東京工業大学 吉瀬謙二) ハザードの分類(制御ハザード)、静的に採用できる制御ハザードの対処(戦略1〜3) / 名古屋大学 嶌田研究室 講義資料「3.4 記憶階層のアーキテクチャ」(chap03text2.pdf) p.18〜20(メモリの平均アクセス時間・メモリインタリーブ)
-
問49.実行中のアプリケーションプログラムが、ユーザーモードでは実行できない入出力などの処理をOSに依頼したときに発生する割込みはどれか。
- ア.入出力割込み
- イ.タイマ割込み
- ウ.プログラム割込み
- エ.SVC割込み
正解:エ.SVC割込み
解説:SVC(スーパーバイザーコール)割込みは、アプリケーションが自分では実行を許されていない処理(入出力装置へのアクセスなど)をOSに依頼するときに発生する内部割込みで、CPUはOSを実行するモード(スーパーバイザーモード)に切り替わる。入出力割込みは入出力装置が入力の終了などを知らせる外部割込みで、依頼した処理が終わったときに起きる。タイマ割込みはインターバルタイマが一定時間ごとに起こす外部割込み、プログラム割込みはゼロ除算やオーバーフローなど実行中のプログラムの異常で起きる内部割込みである。
根拠: IPA 応用情報技術者試験(レベル3)シラバス Ver.7.2 中分類3:コンピュータ構成要素 1.プロセッサ(6)プロセッサの動作原理 ③ 割込み 用語例「SVC(SuperVisor Call)割込み,入出力割込み,プログラム割込み」(PDF p.19・本文 p.15)/中分類5:ソフトウェア 1.オペレーティングシステム(2)OS の機能と構成 用語例「カーネルモード(スーパーバイザーモード),ユーザーモード」(PDF p.27・本文 p.23) / オペレーティングシステム #2(名古屋工業大学 講義資料) 割込みの種類(内部割込み:スーパバイザコール割込み・プログラムチェック(例外)割込み/外部割込み:入出力割込み・タイマ割込み ほか)、SVC割込みとユーザモード・スーパバイザモード、入出力割込み(入力の終了を知らせる)、タイマ割込み(PDF p.16〜26)
-
問50.組込みシステムのリアルタイム処理要件のうち、期限遵守が絶対要件となるものはどれか。
- ア.ハードリアルタイム
- イ.ソフトリアルタイム
- ウ.ベストエフォート
- エ.ノンリアルタイム
正解:ア.ハードリアルタイム
解説:ハードリアルタイムは、すべての期限を例外なく守らなければならず、1回でも期限に遅れればシステムの失敗とみなす方式で、航空機の飛行制御などが当たる。ソフトリアルタイムは、ときどき期限に遅れても失敗とはせず、性能の低下として許容する。ベストエフォートは、できる限り努力はするが速度や品質を保証しない方式なので、期限を守ることも保証しない。ノンリアルタイムは、処理の速さが結果の正しさの条件にならない通常の処理で、期限という要件そのものを持たない。なお、遅れた結果は捨てるが失敗とはしないファームリアルタイムという区分もある。
根拠: Real-time systems (IEEE Technology Navigator) 冒頭の段落(期限後の結果は誤りとして扱う・通常の処理では速さは性能の問題で正しさの条件ではない)と次の段落(hard/soft/firm real-time の区別) / コトバンク「ベストエフォート型」(小学館 デジタル大辞泉/講談社 IT用語がわかる辞典) 通信速度や品質が保証されないデータ通信サービスの形態。できる限り努力はするが、諸条件によって通信速度の低下などが生じることがある / IPA 応用情報技術者試験 シラバス Ver.7.2 PDF 12ページ(本文 -8-)(2)制御に関する理論 ① 制御の考え方,仕組み 用語例「リアルタイムOS」
-
問51.2進数の101101を10進数に変換すると、46である。
正解:×(誤り)
解説:誤り。32+8+4+1=「45」(46ではない)。
-
問52.16進数のFFは、10進数で256である。
正解:×(誤り)
解説:誤り。FF(16) = 15×16 + 15 = 255(10)。FFは8ビットの最大値。
根拠: MDN Web Docs: Number.prototype.toString() Examples(基数変換の例)
-
問53.浮動小数点数の精度を高めるには、仮数部のビット数を増やせばよい。
正解:○(正しい)
解説:IEEE754等の浮動小数点形式:仮数部のビット数が精度を、指数部が範囲を決定する。倍精度(64bit)は仮数部52bit。
根拠: 18.3.3 浮動小数点表現の精度・範囲と特別な値(東京大学 教養教育高度化機構 情報・数理) 「浮動小数点の精度」の節
-
問54.O(n log n)はO(n)よりも漸近的に増加が遅い。
正解:×(誤り)
解説:誤り。O(n log n)はO(n)より「漸近的に速い増加」(log n倍だけ大きい)。
根拠: big-O notation, Dictionary of Algorithms and Data Structures (NIST) Definition / Formal Definition / little-o notation, Dictionary of Algorithms and Data Structures (NIST) Definition
-
問55.バブルソートの平均計算量はO(n²)である。
正解:○(正しい)
解説:正しい。バブルソートは、隣り合う2つの要素の順序が逆なら交換する操作を繰り返して整列する。n個(nは要素の数)の列では、1回目の走査でn−1回、2回目でn−2回…と比べ、合計(n−1)+(n−2)+…+1=n(n−1)/2回の比較をする。この基本の形では比較の回数が入力の並び方によらないので、平均でも最悪でもO(n²)になる。選択ソート・挿入ソートも平均・最悪ともO(n²)。これに対しクイックソートは平均O(n log n)だが、最悪はO(n²)になる。
根拠: 首都大学東京 内田幸寛「アルゴリズムB 第6回 ソートアルゴリズム」(2021) p.1「バブルソート」(隣接している要素の順序が逆のとき交換する操作を繰り返す。for j = 1 to n−1/for i = 1 to n−j の擬似コード) / 首都大学東京 内田幸寛「アルゴリズムB 第8回 比較によらないソート・中間まとめ」(2021) p.1 の表(最悪計算量・平均計算量:バブルソート・挿入ソート・選択ソートは O(n²)・O(n²)、クイックソートは O(n²)・O(n log n)。平均はすべての順列が一様に現れるとした評価)
-
問56.スタックはFIFO(先入れ先出し)、キューはLIFO(先入れ後出し)のデータ構造である。
正解:×(誤り)
解説:誤り。スタックは最後に入れた要素から取り出す LIFO(後入れ先出し)のデータ構造である。キューは最初に入れた要素から取り出す FIFO(先入れ先出し)のデータ構造である。問題文は両者の対応が逆になっている。スタックは積んだ皿の上から取る、キューは行列の先頭から進むと覚える。
根拠: NIST Dictionary of Algorithms and Data Structures「stack」 Definition / NIST Dictionary of Algorithms and Data Structures「queue」 Definition
-
問57.二分探索木では、平均的に探索の計算量はO(log n)である。
正解:○(正しい)
解説:正しい。二分探索木は、どの節でも左の部分木にその節より小さいキー、右の部分木に大きいキーが入るように並べた木で、探索では根から目的のキーと比べて左右どちらかへ1段ずつ下りる。比べる回数は木の高さで決まり、平均的な高さはO(log n)(nはデータの数)なので、探索も平均O(log n)になる。ただし、データの追加の順によっては木が一方に偏って連結リストのような形になり、最悪O(n)かかる。AVL木・赤黒木などの平衡木は木の形の偏りを抑え、最悪の場合もO(log n)で探索できる。
根拠: データ構造とアルゴリズム 第7回: 辞書とその実装: 二分木など(青山学院大学 理工学部情報テクノロジー学科) 「二分探索木」「探索木での探索」(左の部分木のキーが小さく右が大きい、根から比べて左右へ進む)、「単純な探索木の評価」(木全体の高さで計算時間が決まる。平均の高さ O(log n)・最悪の高さ O(n))、「平衡木」(一般の探索木は最悪、連結リストの形を取る) / データ構造とアルゴリズム 第8回: 平衡木(青山学院大学 理工学部情報テクノロジー学科) 「赤黒木」(葉の最大の深さは最小の深さの二倍以内)、「AVL 木」(左右の部分木の高さの差は1以下、高さが 1.44 log₂ n に限定)、「まとめ」(平衡木によって辞書の基本操作は全て O(log n) で可能)
-
問58.ハッシュテーブルの平均探索計算量は、O(1)である。
正解:○(正しい)
解説:ハッシュテーブル:平均O(1)、最悪O(n)(全衝突時)。良いハッシュ関数で衝突を最小化。
根拠: NIST Dictionary of Algorithms and Data Structures: hash table hash table の項の Note
-
問59.コンパイラは、ソースコードを実行時に逐次解釈するプログラムである。
正解:×(誤り)
解説:誤り。コンパイラは「実行前に機械語変換」(実行時解釈はインタプリタ)。
根拠: JIS X 0007:2001 情報処理用語-プログラミング 07.02 方法,技法及びプログラム構造 付近の「コンパイルする」「コンパイラ」の項
-
問60.オブジェクト指向の3要素は、関数・配列・分岐である。
正解:×(誤り)
解説:誤り。OOP3要素は「カプセル化・継承・ポリモーフィズム」(プログラミング基本要素ではない)。
根拠: Object-oriented programming - inheritance - C# (Microsoft Learn) 冒頭の段落
-
問61.プロセスはOSが管理する実行単位、スレッドはプロセス内で並行実行できる軽量な単位である。
正解:○(正しい)
解説:正しい。プロセスは実行中のプログラムで、OSが仮想アドレス空間などの資源を割り当てて管理する単位である。スレッドはプロセスの中で実行される流れで、1つのプロセスに複数作ることができ、OSがプロセッサの時間を割り当てる基本の単位になる。同じプロセスのスレッドは仮想アドレス空間と資源を共有し、自分のレジスタとスタックだけを別に持つ。このためスレッドどうしの切替えではアドレス空間(ページテーブル)を切り替えずに済み、プロセスより軽く扱える。
根拠: Processes and Threads - Win32 apps (Microsoft Learn) 冒頭の概要の段落(A process is an executing program. A thread is the basic unit to which the operating system allocates processor time.) / About Processes and Threads - Win32 apps (Microsoft Learn) 冒頭の段落(プロセスは仮想アドレス空間などの資源を持ち、追加のスレッドを作れる。プロセスの全スレッドは仮想アドレス空間とシステム資源を共有し、各スレッドはレジスタ・カーネルスタック・ユーザースタックなどのスレッドコンテキストを持つ) / Operating Systems: Three Easy Pieces(R. H. Arpaci-Dusseau・A. C. Arpaci-Dusseau) Chapter 26 Concurrency: An Introduction p.1(スレッドは同じアドレス空間を共有し、各スレッドは自分のレジスタを持つ。スレッド間のコンテキストスイッチではアドレス空間はそのままで、ページテーブルを切り替える必要がない)
-
問62.デッドロックとは、複数のプロセスが互いに資源解放を待つ状態で進行不能になる現象である。
正解:○(正しい)
解説:正しい。デッドロックは、複数のプロセスがそれぞれ資源を持ったまま、ほかのプロセスが持つ資源の解放を待ち合い、どれも先へ進めなくなる状態をいう。発生するには、相互排除・保有と待機・横取り不可・循環待機の4条件(Coffman条件)がすべて成り立つ必要があり、このうち1つでも成り立たないようにすれば発生を防止できる。これに対し、各プロセスに必要な資源の最大量を前もって申告させ、危険な状態につながる割当て要求を断る銀行家アルゴリズム(バンカーズアルゴリズム)の方法は、回避と呼ぶ。
根拠: 会津大学オンラインジャッジ「デッドロック検出」問題文 問題文冒頭(デッドロックの定義:複数のスレッドがお互いにいくつかの資源を使い終わるのを待っていて先に進めない状況) / デジタル大辞泉「デッドロック」(コトバンク) 語義2(プログラム間で互いの処理終了を待つなどして半永久的な待機状態に陥ること) / UC Riverside CS 153 Design of Operating Systems (Fall 2020) Lecture 14: Deadlock(講義スライド) p.3 Deadlock Definition、p.6 Conditions for Deadlock(4条件が同時に成り立つときに限り発生)、p.13 Deadlock Prevention(必要条件の少なくとも1つが起きないようにする)、p.15〜16 Deadlock Avoidance・Banker's Algorithm(最大要求量を前もって申告・危険な状態につながる要求を拒否)、p.22 まとめ
-
問63.スワッピングとは、CPU使用率を上げるために実行可能なプロセスの優先度を変えることである。
正解:×(誤り)
解説:誤り。スワッピング:物理メモリ不足時にプロセスのデータを補助記憶(HDD/SSD)に退避すること。優先度変更ではない。
根拠: IPA 応用情報技術者試験 シラバス Ver.7.2 PDF 28ページ(本文 -24-)(7)記憶管理 ① 実記憶管理「主記憶装置を効率良く使うためのスワッピング」、用語例 ロールイン・ロールアウト・スワップイン・スワップアウト / コトバンク「スワップ」(小学館 デジタル大辞泉/講談社 IT用語がわかる辞典) デジタル大辞泉 語義2(メモリーに収まりきらない情報を一時的に記憶装置に書き出し、必要に応じてメモリー内の情報と交換すること)、IT用語がわかる辞典(メインメモリー上のデータを一時的にハードディスク上に移す。「スワッピング」ともいう)
-
問64.仮想記憶は、物理メモリ容量を超えたメモリ空間をプロセスに提供する機能である。
正解:○(正しい)
解説:仮想記憶:ページング・セグメンテーションで実現。プロセスから見た連続的な仮想空間を、物理メモリ+補助記憶にマッピング。
根拠: JIS X 0010:1987 情報処理用語(操作技法及び機能) 10.05 記憶管理 10.05.11 仮想記憶(仮想記憶装置)の定義と注 / 32 ビット バージョンの Windows の仮想メモリ - Windows Server ページファイルの節
-
問65.システムの稼働率は、MTBFが短くMTTRが長いほど高くなる。
正解:×(誤り)
解説:誤り。稼働率はMTBF「長く」MTTR「短い」ほど高い(故障少なく修復早い)。
根拠: JAIST i450 workbook and errata(稼働率、MTBF、MTTR の項) 「稼働率、MTBF、MTTR」の段落
-
問66.クラスタリングは、複数のサーバを連携させて1つのシステムとして運用する技術である。
正解:○(正しい)
解説:正しい。クラスタリングは、複数のコンピュータを接続し、全体を一つのシステムとして機能させる技術である。独立した複数のシステムを一つとして動かすので、障害が起きても全体を止めずに運用を続けられ、台数を増やせば耐障害性と性能も高められる。「複数台で1台のように動く」と覚える。
根拠: クラスタリング(デジタル大辞泉) - コトバンク(出典:教育ネットワーク情報セキュリティ推進委員会 情報セキュリティ用語辞典) クラスタリング項目
-
問67.中置記法の式 (A+B)×C を逆ポーランド表記法で表すと、A B C + × となる。
正解:×(誤り)
解説:誤り。逆ポーランド表記法(後置記法)では演算子を被演算子の後ろに置くので、(A+B)×C は A B + C × となる。A B C + × は A×(B+C) を表す。
根拠: オートマトンと言語 2回目 授業資料(山梨大学) 数式の記法(3):(x+y)*z を後置記法に変換すると xy+z*
-
問68.M/M/1モデルでは、利用率ρが1に近づくほど待ち時間は短くなる。
正解:×(誤り)
解説:誤り。利用率ρは窓口が処理に使われている時間の割合で、平均到着率×平均サービス時間(=平均到着率÷平均サービス率)で求める。M/M/1 の平均待ち時間は、平均サービス時間×ρ÷(1−ρ) で表される。ρが1に近づくと分母の (1−ρ) が0に近づくので、待ち時間は短くなるのではなく急激に長くなる。たとえばρが0.9なら平均待ち時間は平均サービス時間の9倍、0.95なら19倍になる。窓口をほとんど休みなく働かせると、混雑して待ちが大きく膨らむということである。
根拠: Dai, J.G. and He, S., Queues in Service Systems: Customer Abandonment and Diffusion Approximations (Tutorials in Operations Research, INFORMS, 2011) p.37〜38 §2(ρ=到着率×平均サービス時間、平均サービス時間 m=1/µ、平均待ち時間 w=m・ρ/(1−ρ)・(1+cs²)/2、M/M/1 は cs²=1、ρ=0.9 で待ち時間係数9・0.95 で19)、Figure 1 / IPA 応用情報技術者試験 シラバス Ver.7.2 PDF 8ページ(本文 -4-)(6)待ち行列理論(M/M/1 モデルにおける計算、用語例 平均到着率・平均サービス率)
-
問69.XORは、2入力が同じとき真、異なるとき偽を返す。
正解:×(誤り)
解説:誤り。XOR(排他的論理和)は「異なるとき真、同じとき偽」(記述が逆)。
根拠: ビット排他的論理和 (^) - JavaScript - MDN Web Docs 冒頭の説明・XOR 演算の真理値表
-
問70.CPUのキャッシュメモリは、主記憶(RAM)よりも高速だが容量が小さい。
正解:○(正しい)
解説:正しい。キャッシュメモリは CPU と主記憶の間(今は多くが CPU の中)に置く小さな高速のメモリで、主記憶より容量は小さいが速く動く。よく使うデータを置いておき、遅い主記憶へ読みに行く回数を減らして処理を速くする。記憶装置は大容量と高速を両立できないため、速いが容量が小さい順に L1→L2→L3 キャッシュ→主記憶と階層に並べ、CPU は L1 から順に探す。これが効くのは、参照したデータやその近くのデータがすぐにまた参照されやすい性質(時間的・空間的局所性)があるからである。
根拠: デジタル大辞泉「一次キャッシュ」(コトバンク) 一次キャッシュの項(CPU内部に設けられ高速で容量が小さい。無い場合は、より低速で容量が大きい二次キャッシュ、三次キャッシュ、主記憶装置の順に読み取りに行く) / コトバンク「キャッシュメモリー」(小学館 日本大百科全書(ニッポニカ)) メインメモリーと比べて容量は小さいが高速に作動する/アクセス頻度の高いデータを保管しメインメモリーへのアクセス回数を減らす/現在ではCPUチップに内蔵されることが多い / 東京大学 OCW「コンピュータハードウェア」第6回 キャッシュ(坂井修一)講義資料 PDF 2ページ「メモリの理想と現実」(大容量と高速アクセスは両立しない)・「記憶階層と局所性」(空間局所性・時間局所性の定義、高速小容量メモリが上位)
-
問71.次のうち、計算量が最も小さいオーダーはどれか。
- ア.O(n²)
- イ.O(log n)
- ウ.O(n)
- エ.O(n log n)
正解:イ.O(log n)
解説:計算量小→大:O(1)<O(log n)<O(n)<O(n log n)<O(n²)<O(2^n)。
-
問72.次のうち、安定(同値の順序保持)なソートアルゴリズムはどれか。
- ア.クイックソート
- イ.ヒープソート
- ウ.マージソート
- エ.選択ソート
正解:ウ.マージソート
解説:マージソート・バブルソート・挿入ソートは安定。クイック・ヒープ・選択は不安定(同値の順序が保持されない場合あり)。
根拠: Sedgewick & Wayne, Algorithms, 4th Edition(Princeton University の教科書サイト)2.5 Sorting Applications Stability の段落(insertion sort and mergesort は安定、selection sort, shellsort, quicksort, heapsort は安定でない) / データ構造とアルゴリズム: クイックソート、平均計算量(青山学院大学 講義資料) 「安定な整列法」の節(定義・ヒープソートとクイックソートは安定でない) / ALDS1_2_C 安定なソート(会津大学 Aizu Online Judge 解説) 安定なソートの定義、選択ソートの不安定な例、バブルソート・挿入ソートは安定なソート
-
問73.次のうち、デッドロック発生の必要条件(Coffman条件)に含まれないものはどれか。
- ア.相互排除
- イ.保有と待機
- ウ.横取り不可
- エ.優先度逆転
正解:エ.優先度逆転
解説:デッドロックは、複数のプロセスが互いに相手の持つ資源の解放を待ち合い、どれも進めなくなる状態で、次の4つの条件がすべて同時に成り立つときにだけ起こる:相互排除(資源を共有できない)、保有と待機(資源を持ったまま別の資源を待つ)、横取り不可(使用中の資源を取り上げられない)、循環待機(待ちの関係が輪になる)。優先度逆転は、優先度の低いプロセスが資源を持っているために優先度の高いプロセスが待たされる現象で、リアルタイム処理で締切りに間に合わなくなるおそれがある問題だが、4条件には含まれない。
根拠: UC Davis ECS 150 (Spring 1999) Four Necessary and Sufficient Conditions for Deadlock(講義資料) Deadlock Conditions(mutual exclusion/hold and wait/no pre-emption/circular wait の4条件) / UC Riverside CS 153 Design of Operating Systems (Fall 2020) Lecture 14: Deadlock(講義スライド) p.2〜3 Deadlock Definition(every thread is waiting for an event that can be caused only by another thread in the set)、p.6 Conditions for Deadlock(if and only if the following four conditions hold simultaneously:Mutual exclusion・Hold and wait・No preemption・Circular wait) / Oracle「System Interface Guide」Chapter 9 Realtime Programming and Administration > Priority Inversion Priority Inversion(Priority inversion is a condition that occurs when a higher priority process is blocked by a lower priority process/低い優先度のプロセスが資源を持つと高い優先度のプロセスが待たされる、長引くと deadlines might be missed)
-
問74.次のうち、仮想化技術の特徴として正しいものはどれか。
- ア.コンテナはホストOSを共有する
- イ.ハイパーバイザ型はゲストOSが不要
- ウ.コンテナはハードウェアを完全仮想化する
- エ.ホスト型はハードウェア上で直接動く
正解:ア.コンテナはホストOSを共有する
解説:コンテナは、1つのホストOSのカーネルを複数のアプリで共有し、アプリどうしを分けて動かす方式で、ハードウェアを仮想化するわけではない。これに対して仮想マシンは、ハイパーバイザが用意する仮想のハードウェアの上で、仮想マシンごとに完全なゲストOSを動かすので、ハイパーバイザ型でもゲストOSは必要である。ハードウェア上で直接動くのはハイパーバイザ型(ベアメタル型)で、ホスト型はホストOSの上でハイパーバイザを動かす方式である。
根拠: NIST Special Publication 800-190 Application Container Security Guide (2017) 2.2(PDF 17〜18ページ)Figure 2 の説明:VM はハイパーバイザによるハードウェアレベルの分離で、各 VM が完全なゲストOSを持つ/コンテナは同じ OS カーネル(ホストOSの一部)を共有する / NIST Special Publication 800-125 Guide to Security for Full Virtualization Technologies (2011) 2.2 Types of Full Virtualization(bare metal はハイパーバイザがホストOSなしでハードウェア上で直接動く/hosted はハイパーバイザがホストOSの上で動く/どちらも各ゲストOSが自分のハードウェアを持つように見える) / IPA 応用情報技術者試験 シラバス Ver.7.2 PDF 24ページ(本文 -20-)(2)システム構成 用語例「仮想化(ホスト型,ハイパーバイザー型,コンテナ型)」
-
問75.システムの稼働率の計算式として正しいものはどれか。
- ア.MTTR / MTBF
- イ.MTBF / (MTBF + MTTR)
- ウ.MTTR / (MTBF + MTTR)
- エ.MTBF / MTTR
正解:イ.MTBF / (MTBF + MTTR)
解説:稼働率は、システムが使える状態にある時間の割合である。MTBF(平均故障間動作時間:故障せずに動いている時間の平均)とMTTR(平均修復時間:故障してから直るまでの時間の平均)を使うと、動いている時間と止まっている時間の合計MTBF+MTTRのうちMTBFが占める割合なので、稼働率=MTBF/(MTBF+MTTR)となる。MTTR/(MTBF+MTTR)は止まっている時間の割合で、1から稼働率を引いた値(アンアベイラビリティ)に当たる。MTBF/MTTRとMTTR/MTBFは動く時間と止まる時間の比で、全体に対する割合ではない。
-
問76.クライアントサーバシステムの元々の構成は、プレゼンテーション層とデータ層からなる2層構成である。
正解:○(正しい)
解説:正しい。2層アーキテクチャは元々のクライアントサーバの構成で、プレゼンテーション層とデータ層からなり、業務ロジックはプレゼンテーション層、データ層、又はその両方に置かれる。2層ではプレゼンテーション層(つまり利用者)がデータ層に直接アクセスする。これに対し、最も広く採用されている多層構成は、プレゼンテーション層・アプリケーション層・データ層に分ける3層アーキテクチャである。
根拠: What Is Three-Tier Architecture? (IBM Think) Other multitier architectures > Two-tier architecture
-
問77.3層クライアントサーバシステムでは、プレゼンテーション層・アプリケーション層・データ層に機能が分離される。
正解:○(正しい)
解説:3層モデル:保守性・スケーラビリティが向上、Webアプリの標準構成。プレゼン(HTML/CSS/JS)・アプリ(Java/PHP等)・DB(RDB等)。
根拠: N-tier architecture style (Azure Architecture Center) N-tier architecture style 本文(three-tier の説明部分)
-
問78.RAID 0は、冗長性が高くデータ保護に優れる。
正解:×(誤り)
解説:誤り。RAID 0は「冗長性なし」(性能向上のみ、ストライピングのみ)。
根拠: Solaris ボリュームマネージャの管理 第8章 RAID-0 ボリュームの概要 RAID-0 ボリュームの概要
-
問79.RAID 1は、容量効率が100%である。
正解:×(誤り)
解説:誤り。RAID 1は「容量効率半分以下」(ミラーリングで2倍ディスク必要)。
根拠: RAID 1 (ミラー) ボリュームの概要 (Solaris ボリュームマネージャの管理) 第9章 RAID 1 (ミラー) ボリューム (概要) の冒頭
-
問80.RAID 5は、いかなる故障でもデータ復旧不可能である。
正解:×(誤り)
解説:誤り。RAID 5は「1台故障時データ復旧可能」(パリティ分散)。
根拠: Linux man-pages md(4)(Linux のソフトウェア RAID ドライバの解説) DESCRIPTION の RAID4(パリティにより1台が故障しても動作を続け、そのデータはパリティと他のブロックから計算できる)・RAID5(RAID4 とほぼ同じでパリティを全デバイスに分散) / コトバンク「RAID」(小学館 日本大百科全書(ニッポニカ)) (6)RAID6(RAID5 で2台同時に故障すると復元できない弱点を解決・パリティを二つ生成し別々のディスクに分散・4台以上を要する)/(4)RAID5
-
問81.RAID 6は、2台のディスクが同時に故障してもデータを保全できる方式である。
正解:○(正しい)
解説:正しい。RAID 6 は、パリティを2つ作ってそれぞれ別のディスクに分散して記録する方式で、2台のディスクが同時に故障しても耐えられ、データを失わない。パリティが1つの RAID 5 は2台が同時に故障すると復元できず、その弱点を補ったのが RAID 6 である。データ用のほかにパリティ2台分の容量が要るので、ディスクは最低4台必要になる。通常時の性能は RAID 5 よりやや低いが、ほぼ同程度である。
根拠: コトバンク「RAID」(小学館 日本大百科全書(ニッポニカ)) (6)RAID6(RAID5 で2台同時に故障すると復元できない弱点を解決・パリティを二つ生成し別々のディスクに分散・4台以上を要する)/(4)RAID5 / Linux man-pages md(4)(Linux のソフトウェア RAID ドライバの解説) DESCRIPTION の RAID6(RAID5 と似ているが任意の2台の喪失にデータを失わずに耐える・N台分のデータに N+2 台が必要・通常時と1台故障時の性能は RAID5 よりやや低いが同程度)
-
問82.バックアップ方式の差分バックアップは、前回フルバックアップ以降に変更されたデータのみをバックアップする。
正解:○(正しい)
解説:差分バックアップ:前回フルバックアップからの変更分。フル+最新差分でリストア。増分(直前との差)よりも復旧シンプル、容量大きめ。
-
問83.増分バックアップは、初回フルバックアップ以降の全変更を毎回バックアップする。
正解:×(誤り)
解説:誤り。増分は「前回バックアップ以降の変更のみ」(毎回全変更は差分バックアップ)。
-
問84.システムのスループットは、単位時間あたりに処理できるトランザクション数等を表す指標である。
正解:○(正しい)
解説:スループット:単位時間処理量(TPS、tps、QPS等)。レスポンスタイム(個々の応答時間)と並んで性能指標の双璧。
-
問85.システムのレスポンスタイムは、ユーザがリクエストしてから応答が返るまでの時間である。
正解:○(正しい)
解説:レスポンスタイム:エンドユーザ視点の応答時間。ターンアラウンドタイム(バッチ処理全体の時間)と区別。
-
問86.フェイルセーフは、システム障害時に危険な状態に移行する設計である。
正解:×(誤り)
解説:誤り。フェイルセーフは「安全な状態に移行」(記述が逆)。
-
問87.フェイルソフトは、システムの一部に障害があっても機能を縮退させながら運転を継続する設計である。
正解:○(正しい)
解説:フェイルソフト:縮退運転。クラスタリング・冗長化(HA)の基本思想。フォールバック動作とも。
-
問88.フールプルーフは、誤操作があっても重大な事故・損傷に至らない設計である。
正解:○(正しい)
解説:フールプルーフ:誤操作防止設計。電子レンジの扉開閉センサー、車のシフトロック等。ヒューマンエラー対策。
-
問89.組込みシステムは、汎用的な機能を実現するシステムである。
正解:×(誤り)
解説:誤り。組込みは「特定機能を機器に組み込む」(汎用ではない)。
-
問90.IoT(Internet of Things)は、様々な機器がインターネットに接続され、データ収集・遠隔制御等が可能になる仕組みである。
正解:○(正しい)
解説:IoT:センサー+通信+クラウド。スマート家電・コネクテッドカー・スマートシティ等で展開。
-
問91.AI(人工知能)の機械学習は、大量のデータからパターンを学習し、予測・分類等を行う技術である。
正解:○(正しい)
解説:機械学習:教師あり学習(分類・回帰)・教師なし学習(クラスタリング)・強化学習等。AIの主要技術。
-
問92.ディープラーニング(深層学習)は、多層のニューラルネットワークを用いた機械学習手法である。
正解:○(正しい)
解説:ディープラーニング:CNN(画像)・RNN/LSTM(時系列)・Transformer(自然言語)等。GPU活用で計算量増加に対応。
-
問93.自然言語処理(NLP)は、人間の言語をコンピュータが理解・生成する技術分野である。
正解:○(正しい)
解説:NLP:機械翻訳・文章要約・感情分析・チャットボット等。LLM(大規模言語モデル)の登場で大きく発展。
-
問94.並列処理のパイプライン方式は、複数の命令を流れ作業のように処理する方式である。
正解:○(正しい)
解説:パイプライン処理:CPU命令を「フェッチ→デコード→実行→書込み」等の段階で重ねて処理。スループット向上。
-
問95.スーパースカラは、1命令ずつ順次実行する技術である。
正解:×(誤り)
解説:誤り。スーパースカラは「複数命令を同時並行実行」(順次は通常実行)。
-
問96.ベンチマークは、システムの性能を比較・評価するための標準的な測定手法である。
正解:○(正しい)
解説:ベンチマーク:SPEC・TPC等の標準ベンチマークがある。新システム選定・性能比較で使用。
-
問97.次のRAID方式のうち、最低4台のディスクが必要なものはどれか。
- ア.RAID 0
- イ.RAID 6
- ウ.RAID 5
- エ.RAID 1
正解:イ.RAID 6
解説:RAID 6:2重パリティで最低4台必要。RAID 0/1は2台、RAID 5は3台から構成可。
-
問98.バックアップ方式のうち、復旧時間が最も短いものはどれか。
- ア.増分バックアップ
- イ.差分バックアップ
- ウ.フルバックアップ
- エ.いずれも同じ
正解:ウ.フルバックアップ
解説:フルバックアップ:単一ファイルから復旧で最速。差分はフル+最新差分、増分はフル+全増分が必要。
-
問99.次のうち、フールプルーフの例として正しいものはどれか。
- ア.監視ログ
- イ.冗長化サーバ
- ウ.バックアップ電源
- エ.電子レンジの扉センサー
正解:エ.電子レンジの扉センサー
解説:フールプルーフ:誤操作防止。電子レンジの扉開時動作停止、シュレッダーの安全装置等が代表例。
-
問100.機械学習の3類型として誤っているものはどれか。
- ア.逆問題学習
- イ.教師なし学習
- ウ.強化学習
- エ.教師あり学習
正解:ア.逆問題学習
解説:機械学習3類型:教師あり・教師なし・強化学習。「逆問題学習」という分類は一般的でない。
-
問101.CPUの並列処理技術として誤っているものはどれか。
- ア.パイプライン処理
- イ.カーネルパニック
- ウ.マルチコア
- エ.スーパースカラ
正解:イ.カーネルパニック
解説:カーネルパニックはOSの致命的エラー、並列処理技術ではない。パイプライン・スーパースカラ・マルチコアは並列処理の代表技術。
-
問102.A,B,C,D を論理変数とするとき,次のカルノー図と等価な論理式はどれか。ここで,・は論理積,+は論理和,X̄ は X の否定を表す。
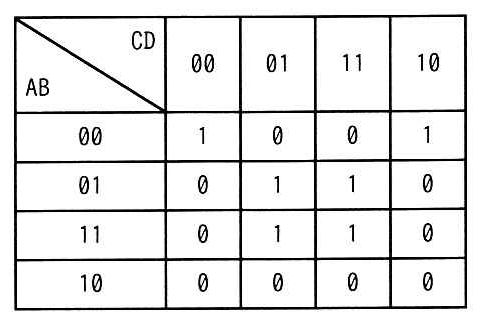
- ア.A・B・C̄・D+B̄・D̄
- イ.Ā・B̄・C̄・D̄+B・D
- ウ.A・B・D+B̄・D̄
- エ.Ā・B̄・D̄+B・D
正解:エ.Ā・B̄・D̄+B・D
解説:1になっているマスをまとめる。まず AB=00 の行の CD=00 と CD=10 が1で,どちらも A=0,B=0,D=0 であり C だけが変わる。C は結果に影響しないのでこの2マスは Ā・B̄・D̄ にまとまる。次に AB=01 と AB=11 の CD=01 と CD=11 の計4マスが1で,どれも B=1,D=1 であり A と C が変わる。よってこの4マスは B・D にまとまる。両者の和で Ā・B̄・D̄+B・D となり,答はエ。アとイは4変数すべてを含む項を残しており,まとめられるマスをまとめていない。ウは第1項が A・B・D で,実際には A=1 のとき B=1・D=1 のマス(AB=11,CD=01と11)だけでなく AB=01 の行も1なので A を含めてはいけない。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問1
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問103.コンピュータによる伝票処理システムがある。このシステムは,伝票データをためる待ち行列をもち,M/M/1 の待ち行列モデルが適用できるものとする。平均待ち時間が T 秒以上となるのは,システムの利用率が少なくとも何%以上となったときか。ここで,伝票データをためる待ち行列の特徴は次のとおりである。 ・伝票データは,ポアソン分布に従って到着する。 ・伝票データをためる数に制限はない。 ・1件の伝票データの処理時間は,平均 T 秒の指数分布に従う。
- ア.33
- イ.50
- ウ.67
- エ.80
正解:イ.50
解説:M/M/1 の平均待ち時間 Tw は,利用率を ρ,平均処理時間を Ts として Tw=ρ/(1−ρ)×Ts で表される。この問題では平均処理時間そのものが T 秒なので Ts=T であり,Tw≧T すなわち ρ/(1−ρ)×T≧T が条件になる。両辺を T で割ると ρ/(1−ρ)≧1 となり,ρ≧1−ρ から ρ≧0.5,つまり利用率50%以上。答はイ。ρ/(1−ρ) は利用率が50%を超えると急激に増える形で,たとえば ρ=0.8 では待ち時間が処理時間の4倍になる。アの33%は ρ/(1−ρ)=0.5,ウの67%は同2,エの80%は同4に当たり,いずれも「待ち時間が処理時間と等しくなる」点ではない。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問2
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問104.AI における機械学習において,2クラス分類モデルの評価方法の一つである ROC 曲線で用いられる偽陽性率の説明として,最も適切なものはどれか。ここで,分類されるデータには正しいものと間違っているものが含まれるものとする。
- ア.“間違い”と予測したデータのうち,実際は“正しい”データの割合
- イ.実際に“間違い”であるデータに対し,誤って“正しい”と予測したデータの割合
- ウ.実際に“間違い”であるデータに対し,正しく“間違い”と予測したデータの割合
- エ.全データのうち,実際に正しく予測できなかったデータの割合
正解:イ.実際に“間違い”であるデータに対し,誤って“正しい”と予測したデータの割合
解説:偽陽性率(False Positive Rate)は,実際には陰性であるデータのうち,誤って陽性と判定してしまった割合をいう。式では FP/(FP+TN) で,分母は「実際に陰性であるデータ全体」である。この問題では“間違い”が陰性,“正しい”が陽性に当たるので,実際に“間違い”であるデータのうち誤って“正しい”と予測した割合となり,答はイ。ROC曲線はこの偽陽性率を横軸,真陽性率を縦軸に取り,判定のしきい値を動かしたときの軌跡を描いたものである。ウは正しく“間違い”と当てた割合で,これは真陰性率(特異度)であり,偽陽性率とは足して1になる関係にある。アは陰性と予測した中での誤りの割合なので分母が予測側であり,適合率の裏返しに当たる。エは全体に対する誤り全体の割合で,誤り率である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問3
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問105.誤り検出方式である CRC に関する記述として,適切なものはどれか。
- ア.検査用のデータは,検査対象のデータを生成多項式で処理して得られる1ビットの値である。
- イ.受信側では,付加されてきた検査用のデータで検査対象のデータを割り,余りがなければ送信が正しかったと判断する。
- ウ.送信側では,生成多項式を用いて検査対象のデータから検査用のデータを作り,これを検査対象のデータに付けて送信する。
- エ.送信側と受信側では,異なる生成多項式が用いられる。
正解:ウ.送信側では,生成多項式を用いて検査対象のデータから検査用のデータを作り,これを検査対象のデータに付けて送信する。
解説:CRC(巡回冗長検査)は,送信するビット列を1つの多項式とみなし,あらかじめ決めた生成多項式で割った余りを検査用データ(CRC符号)として末尾に付けて送る方式である。受信側は「データ+CRC符号」を同じ生成多項式で割り,余りが0なら誤りなしと判断する。したがって答はウ。アは,余りのビット数は生成多項式の次数で決まり,CRC-32なら32ビットになるので「1ビット」が誤り。1ビットで表すのはパリティである。イは割る数を取り違えている。割るのは生成多項式であって,付加されてきた検査用データではない。エは,送信側と受信側が同じ生成多項式を使わなければ余りの計算が一致せず検査が成り立たないので誤り。CRCはバースト誤り(連続したビットの誤り)の検出に強く,通信やストレージで広く使われている。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問4
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問106.記憶領域を管理するアルゴリズムのうち,ベストフィット方式の特徴として,適切なものはどれか。
- ア.空きブロック群のうち,アドレスが下位のブロックを高い頻度で使用するので,アドレスが上位の方に大きな空きブロックが残る傾向にある。
- イ.空きブロック群のうち,要求された大きさを満たす最小のものを割り当てるので,最終的には小さな空きブロックが多数残る傾向にある。
- ウ.空きブロックの検索にハッシュ関数を使用しているので,高速に検索することができる。
- エ.空きブロックをアドレスの昇順に管理しているので,隣接する空きブロックを簡単に見つけられ,より大きな空きブロックにまとめることができる。
正解:イ.空きブロック群のうち,要求された大きさを満たす最小のものを割り当てるので,最終的には小さな空きブロックが多数残る傾向にある。
解説:ベストフィット方式は,空きブロックの中から「要求された大きさを満たすもののうち最も小さいもの」を選んで割り当てる方式である。ぴったりに近いブロックを使うので一見むだがないように見えるが,割り当てのたびにわずかな端数が残るため,どの要求にも使えない小さな空きブロックが多数散らばる。これが外部フラグメンテーションで,答はイ。アはファーストフィット方式の説明で,先頭から探して最初に見つかった空きブロックを使うため下位アドレスばかりが使われる。ウは検索の実装方式の話であり,ベストフィットかどうかとは別の観点である。エは空きブロックをアドレス順に並べて管理する目的(隣接ブロックの併合)の説明で,どの方式でも併用できる管理方法である。なお最も大きい空きブロックを割り当てるのはワーストフィット方式で,端数が大きく残るので細かい断片が生じにくい。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問5
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問107.異なる n 個のデータが昇順に整列された表がある。この表を m 個のデータごとのブロックに分割し,各ブロックの最後尾のデータだけを線形探索することによって,目的のデータの存在するブロックを探し出す。次に,当該ブロック内を線形探索して目的のデータを探し出す。このときの平均比較回数を表す式はどれか。ここで,m は十分に大きく,n は m の倍数とし,目的のデータは必ず表の中に存在するものとする。
- ア.m+n/m
- イ.m/2+n/(2m)
- ウ.n/m
- エ.n/(2m)
正解:イ.m/2+n/(2m)
解説:探索は2段階に分かれるので,それぞれの平均比較回数を出して足す。まずブロックの数は n/m 個で,各ブロックの最後尾を先頭から順に見ていくから,目的のブロックに当たるまでの平均比較回数はその半分の n/(2m) 回になる。次に見つけたブロックの中は m 個のデータを線形探索するので,平均は m/2 回である。合計すると m/2+n/(2m) となり,答はイ。アは両方とも半分にせず,しかもブロック内を m 回すべて比較する形で最悪値に近い。ウはブロックを探す段階だけを最悪値で数えており,ブロック内の探索が抜けている。エはブロックを探す段階の平均だけで,やはりブロック内が抜けている。この方式はブロック探索法と呼ばれ,m=√n のときに全体の比較回数が最小の √n 程度になる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問6
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問108.OSS として公開されているプログラム言語である Scala の特徴はどれか。
- ア.オブジェクト指向プログラミングと関数型プログラミングの両方が可能である。
- イ.クラスの多重継承が可能である。
- ウ.実行前にコンパイルして,ネイティブコードを生成する必要がある。
- エ.変数の型が,参照する実際の値によって実行時に決定される動的型付け言語である。
正解:ア.オブジェクト指向プログラミングと関数型プログラミングの両方が可能である。
解説:Scala は,オブジェクト指向と関数型の両方の書き方を1つの言語で扱えるように設計された言語である。すべての値がオブジェクトである一方,関数も値として扱えて高階関数やパターンマッチが使える。よって答はア。イは誤りで,Scala はクラスの多重継承を許さず,代わりにトレイトという仕組みで複数の性質を混ぜ込む。ウも誤りで,Scala のソースは通常 Java の中間コード(バイトコード)にコンパイルされ,JVM 上で動く。ネイティブコードの生成は必須ではない。エも誤りで,Scala は変数の型がコンパイル時に決まる静的型付け言語である。ただし型推論が強力なので明示的な型宣言を書かなくてよい場面が多く,動的型付けのように見えることがある。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問7
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問109.プロセッサの高速化技法の一つとして,同時に実行可能な複数の動作を,コンパイルの段階でまとめて一つの複合命令とし,高速化を図る方式はどれか。
- ア.CISC
- イ.MIMD
- ウ.RISC
- エ.VLIW
正解:エ.VLIW
解説:VLIW(Very Long Instruction Word)は,同時に実行できる複数の演算をコンパイラがあらかじめ見つけ出し,それらを1つの長い命令語にまとめておく方式である。実行時にどの命令を並列に流せるかを判断する回路が要らないので,ハードウェアを簡単にしたまま並列度を上げられる。よって答はエ。アの CISC は1命令で複雑な処理を行う命令体系の考え方で,並列実行のためのまとめ方ではない。イの MIMD はフリンの分類の一つで,複数のプロセッサがそれぞれ異なる命令で異なるデータを処理する構成を指し,命令のまとめ方の話ではない。ウの RISC は命令を単純・固定長にして1命令あたりの実行を速くする考え方である。なお,実行時にハードウェアが並列実行の可否を判断する方式はスーパースカラと呼ばれ,VLIW と対になる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問8
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問110.画面表示用フレームバッファがユニファイドメモリ方式であるシステムの特徴はどれか。
- ア.主記憶とは別に専用のフレームバッファをもつ。
- イ.主記憶の一部を表示領域として使用する。
- ウ.シリアル接続した表示デバイスに,描画コマンドを用いて表示する。
- エ.表示リフレッシュが不要である。
正解:イ.主記憶の一部を表示領域として使用する。
解説:ユニファイドメモリ方式は,画面表示に使うフレームバッファを専用に用意せず,主記憶の一部を割り当てて共用する方式である。専用メモリが不要なので低コストにできる反面,CPU のメモリアクセスと表示のための読み出しが同じ主記憶に集中するため,帯域を奪い合って性能が落ちやすい。よって答はイ。アは逆に専用のビデオメモリをもつ方式の説明である。ウは描画コマンドを送って表示側で描かせる方式の説明で,メモリをどこに置くかとは別の観点である。エの表示リフレッシュは,画面を一定周期で書き換え続ける動作のことで,メモリの持ち方に関係なく必要である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問9
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
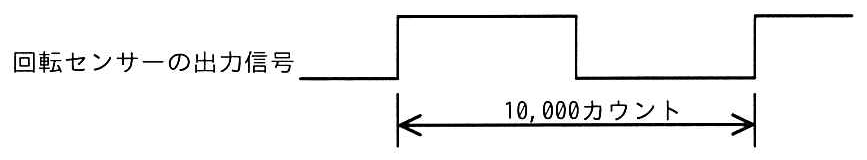
問111.モーターの軸に装着された回転センサーから出力されるパルスの周期を,1MHz のクロック周波数でカウントアップするタイマーで計測したところ,10,000 カウントであった。モーターの回転数は毎秒何回転か。ここで,回転センサーはモーターの軸が1回転するごとに図のようなパルスを2回出力するものとする。
- ア.50
- イ.100
- ウ.200
- エ.5,000
正解:ア.50
解説:まずカウント値を時間に直す。1MHz のクロックは1カウントが 1/1,000,000 秒=1マイクロ秒なので,10,000 カウントは 10,000×1μs=10ミリ秒である。図から,この 10,000 カウントはパルス1周期分にあたる。回転センサーは軸が1回転するごとにパルスを2回出すので,1回転にかかる時間はパルス2周期分の 10ms×2=20ミリ秒=0.02秒。したがって毎秒の回転数は 1÷0.02=50回転となり,答はア。イの100は,1回転あたり2パルスであることを見落として 1÷0.01 としてしまった値である。ウの200はさらに周期を半分に取り違えた場合の値。エの5,000は,カウント値10,000をそのまま回転周期のマイクロ秒数と誤って扱った場合などに出る値で,桁が2つ違う。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問10
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問112.現状の HPC(High Performance Computing)マシンの構成を,次の条件で更新することにした。更新後の,ノード数と総理論ピーク演算性能はどれか。ここで,総理論ピーク演算性能は,コア数に比例するものとする。 〔現状の構成〕 (1) 一つのコアの理論ピーク演算性能は 10 GFLOPS である。 (2) 一つのノードのコア数は8である。 (3) ノード数は 1,000 である。 〔更新条件〕 (1) 一つのコアの理論ピーク演算性能を現状の2倍にする。 (2) 一つのノードのコア数を現状の2倍にする。 (3) 総コア数を現状の4倍にする。
- ア.ノード数 2,000 / 総理論ピーク演算性能 320 TFLOPS
- イ.ノード数 2,000 / 総理論ピーク演算性能 640 TFLOPS
- ウ.ノード数 4,000 / 総理論ピーク演算性能 320 TFLOPS
- エ.ノード数 4,000 / 総理論ピーク演算性能 640 TFLOPS
正解:イ.ノード数 2,000 / 総理論ピーク演算性能 640 TFLOPS
解説:まず現状を押さえる。総コア数は 8コア×1,000ノード=8,000コアで,総理論ピーク演算性能は 10GFLOPS×8,000=80,000GFLOPS=80TFLOPS である。更新後は総コア数が4倍なので 8,000×4=32,000コア。1ノードのコア数は2倍の16コアになるから,ノード数は 32,000÷16=2,000ノードで,現状と同じ1,000ではなく2倍になる点に注意する。総理論ピーク演算性能は,コア1つの性能が2倍の20GFLOPSになり,コア数が4倍になるので 20GFLOPS×32,000コア=640,000GFLOPS=640TFLOPS。よってノード数2,000・640TFLOPS のイが答。ウとエのノード数4,000は,総コア数の4倍をそのままノード数に当てはめ,1ノードあたりのコア数も2倍になることを見落とした値である。アとウの320TFLOPSは,コア数4倍だけを掛けてコア単体の性能が2倍になることを反映していない値である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問11
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問113.IaC(Infrastructure as Code)の説明として,適切なものはどれか。
- ア.OS,仮想化ソフトなどが何もインストールされていない,初期状態のサーバである。
- イ.サーバなどの新規利用申請があった場合に,資源の割当て,設定などを手動で行い,利用可能な状態にする。
- ウ.システムの構成,設定などをプログラムとして記述し,専用のソフトウェアがその内容に従って自動的にシステムに適用する。
- エ.利用者は,OS,アプリケーションなどの任意のソフトウェアをインフラストラクチャに手動で実装し,操作することができる。
正解:ウ.システムの構成,設定などをプログラムとして記述し,専用のソフトウェアがその内容に従って自動的にシステムに適用する。
解説:IaC は,サーバやネットワークといったインフラの構成・設定を,手作業ではなくコード(プログラム)として書き,専用のツールがそのコードのとおりに環境を作る考え方である。設定内容がテキストとして残るのでバージョン管理でき,同じコードから何度でも同一の環境を再現できる。よって答はウ。アはベアメタルサーバの説明で,コード化とは関係がない。イとエはどちらも「手動で行う」と書いてあり,自動化を本質とする IaC と正反対である。代表的なツールに Terraform や Ansible があり,構成のずれ(設定ドリフト)を防ぐ効果も大きい。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問12
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問114.コンピュータシステムの信頼性に関する記述のうち,適切なものはどれか。
- ア.MTBF/(MTBF+MTTR) は,システムが稼働している時間の割合を表す。
- イ.MTBF−MTTR は,システムが正常であった時間を表す。
- ウ.MTBF は,正常なシステムが運用を開始してから初めて故障が起きるまでの時間を表す。
- エ.MTTR は,システムの故障が回復した時点から次に故障が起きるまでの平均時間を表す。
正解:ア.MTBF/(MTBF+MTTR) は,システムが稼働している時間の割合を表す。
解説:MTBF は平均故障間隔(故障から次の故障までの平均時間),MTTR は平均修復時間である。全体の時間は「動いていた時間+直していた時間」=MTBF+MTTR なので,そのうち動いていた割合,すなわち稼働率は MTBF/(MTBF+MTTR) で表される。よって答はア。イの MTBF−MTTR は,性質の違う2つの平均時間を引いたもので,意味のある指標にはならない。ウは,運用開始から初めて故障するまでの平均時間を指すのは MTTF(平均故障時間)で,MTBF は修理して使い続ける装置について故障と故障の間隔を表すものなので誤り。エは MTBF の説明になっており,MTTR と取り違えている。MTTR は故障が起きてから復旧するまでにかかる平均時間である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問13
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問115.キャパシティプランニングの目的の一つに関する記述のうち,最も適切なものはどれか。
- ア.応答時間に最も影響があるボトルネックだけに着目して,適切な変更を行うことによって,そのボトルネックの影響を低減又は排除することである。
- イ.システムの現在の応答時間を調査して,長期的に監視することによって,将来を含めて応答時間を維持することである。
- ウ.ソフトウェアとハードウェアをチューニングして,現状の処理能力を最大限に引き出して,スループットを向上させることである。
- エ.パフォーマンスの問題はリソースの過剰使用によって発生するので,特定のリソースの有効利用を向上させることである。
正解:イ.システムの現在の応答時間を調査して,長期的に監視することによって,将来を含めて応答時間を維持することである。
解説:キャパシティプランニングは,業務量の増加を予測したうえで,将来にわたって必要な性能を保てるように資源の量と増強の時期を計画する活動である。現在の応答時間や資源の使用状況を継続して測り,傾向から将来の不足時期を見積もる点が中心なので,答はイ。アはボトルネックの特定と除去で,これはチューニングの作業である。ウも現状の資源から最大限の性能を引き出す話でチューニングに当たる。エは特定資源の使用効率を上げる話で,やはり現状最適化である。ア・ウ・エはいずれも「今ある資源をどう使い切るか」であるのに対し,キャパシティプランニングは「これからどれだけ資源が要るか」を扱う点が違う。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問14
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
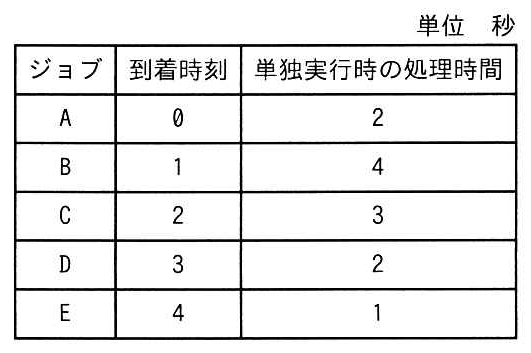
問116.五つのジョブA〜Eに対して,ジョブの多重度が1で,処理時間順方式のスケジューリングを適用した場合,ジョブBのターンアラウンドタイムは何秒か。ここで,OS のオーバーヘッドは考慮しないものとする。
- ア.8
- イ.9
- ウ.10
- エ.11
正解:エ.11
解説:処理時間順方式(SPT)は,その時点で待っているジョブのうち処理時間が最も短いものから実行する方式である。多重度1なので1本ずつ順に流す。時刻0はAしか到着していないのでAを実行し,0〜2秒で終わる。時刻2の時点で待っているのはB(4秒)とC(3秒)で,短いCを選び2〜5秒。時刻5ではB(4秒)・D(2秒)・E(1秒)が待っており,最短のEを選んで5〜6秒。時刻6ではB(4秒)とD(2秒)が待つのでDを選び6〜8秒。最後にBが8〜12秒で実行される。ターンアラウンドタイムは到着から完了までなので,Bは到着1秒・完了12秒で 12−1=11秒。答はエ。処理時間の長いジョブは後回しにされ続けるため待ち時間が伸びるという,この方式の性質がそのまま表れている。アの8はBの開始時刻をそのまま答えた場合の値である。イの9とウの10は,完了時刻12から引く到着時刻を表の別の行から取った場合(Dの3なら9,Cの2なら10)に出る値で,Bの到着は1である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問15
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問117.一つの I²C バスに接続された二つのセンサーがある。それぞれのセンサー値を読み込む二つのタスクを排他的に制御したい。利用するリアルタイム OS の機能として,適切なものはどれか。
- ア.キュー
- イ.セマフォ
- ウ.マルチスレッド
- エ.メモリプール
正解:イ.セマフォ
解説:セマフォは,同時に使える数を数え上げて管理し,資源が空くまでタスクを待たせる仕組みである。使える数を1に設定すれば,同時に1つのタスクしか資源を使えなくなり,排他制御が実現できる。この問題では I²C バスという1本の通信路を2つのタスクが取り合うので,セマフォで守るのが適切であり答はイ。アのキューはタスク間でデータを順番に受け渡すための仕組みで,通信路そのものを守る用途ではない。ウのマルチスレッドは1つのプログラムを複数の流れで動かす方式の名前で,排他制御の機能ではない。エのメモリプールは,あらかじめ確保した領域から固定長のメモリを高速に貸し出す仕組みである。なお I²C は1本のバスを複数のデバイスが共有するので,読み出しの途中で別のタスクが割り込むと通信が壊れる。だからこそ排他制御が要る。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問16
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問118.スレッドセーフの説明として,適切なものはどれか。
- ア.アプリケーションが複数のスレッドから呼び出されないようになっている。
- イ.アプリケーションを複数のスレッドではなく,単一のスレッドで動作させる。
- ウ.アプリケーションを複数のスレッドで並列に実行しても,問題が生じない。
- エ.スレッドの競合が発生したときに,アプリケーションを安全に停止させる。
正解:ウ.アプリケーションを複数のスレッドで並列に実行しても,問題が生じない。
解説:スレッドセーフとは,複数のスレッドから同時に呼び出されても正しく動作する性質をいう。共有するデータへのアクセスを排他制御で守る,あるいはそもそも共有状態を持たない作りにすることで実現する。よって答はウ。アは「複数スレッドから呼ばれない」,イは「単一スレッドで動かす」で,どちらも同時実行そのものを避ける話であり,同時に呼ばれても正しく動くというスレッドセーフの定義とは違う。エは競合が起きたら止めるという話で,止まってしまう時点で正しく動作していない。スレッドセーフでない処理を複数スレッドから呼ぶと,読み書きの順序が交錯して値が壊れる競合状態(レースコンディション)が起きる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問17
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問119.二つのタスクが共用する二つの資源を排他的に使用するとき,デッドロックが発生するおそれがある。このデッドロックの発生を防ぐ方法はどれか。
- ア.一方のタスクの優先度を高くする。
- イ.資源獲得の順序を両方のタスクで同じにする。
- ウ.資源獲得の順序を両方のタスクで逆にする。
- エ.両方のタスクの優先度を同じにする。
正解:イ.資源獲得の順序を両方のタスクで同じにする。
解説:デッドロックは,タスクAが資源1を持ったまま資源2を待ち,タスクBが資源2を持ったまま資源1を待つ,という循環した待ちができたときに起きる。獲得の順序を両方とも「資源1→資源2」にそろえておけば,先に資源1を取れた側が資源2も取れるので循環が生じない。よって答はイ。ウは順序を逆にする,つまりまさに循環待ちを作る条件そのもので,デッドロックを起こしやすくする。アとエの優先度は,どちらのタスクが先に走るかを変えるだけで,互いに相手の持つ資源を待つ構図は解消しない。優先度を上げても,相手が資源を握って離さない限り待ち続けることになる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問18
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
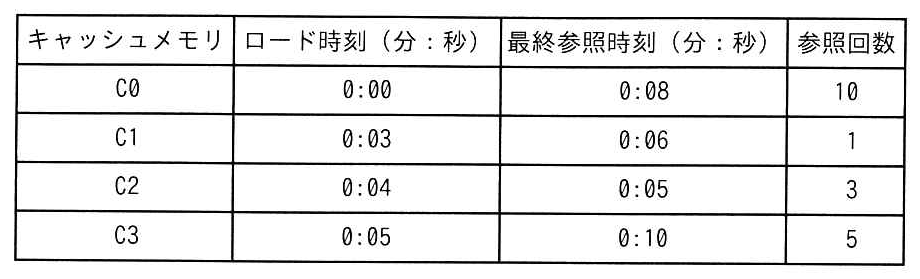
問120.4ブロックのキャッシュメモリ C0〜C3 が表に示す状態である。ここで,新たに別のブロックの内容をキャッシュメモリにロードする必要が生じたとき,C2 のブロックを置換の対象とするアルゴリズムはどれか。
- ア.FIFO
- イ.LFU
- ウ.LIFO
- エ.LRU
正解:エ.LRU
解説:4つの方式で選ばれるブロックをそれぞれ確かめる。FIFO は最も早くロードされたものを追い出すので,ロード時刻が 0:00 の C0 が対象になる。LFU は参照回数が最も少ないものなので,1回の C1 が対象。LIFO は最後にロードされたものだから,0:05 の C3 が対象。LRU は最後に参照された時刻が最も古いものを追い出す方式で,最終参照時刻は C0 が 0:08,C1 が 0:06,C2 が 0:05,C3 が 0:10 だから,最も古い C2 が対象になる。よって答はエ。表にはロード時刻・最終参照時刻・参照回数の3つが並んでいて,どの列を見るかで答が変わる作りになっている。LRU が見るのは最終参照時刻であって,ロード時刻でも参照回数でもない点が要である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問19
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
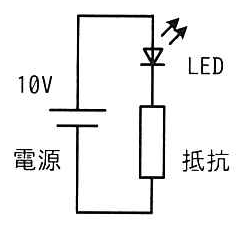
問121.図の LED 点灯回路において,LED に10ミリAの電流が流れるように抵抗値を決定したときに,回路全体の消費電力に占める LED の消費電力の割合は何%か。ここで,LED の順方向電圧は2Vとし,電源の消費電力は無視するものとする。
- ア.20
- イ.25
- ウ.80
- エ.100
正解:ア.20
解説:LEDと抵抗は直列なので,どちらにも同じ10ミリAが流れる。LED の消費電力は,順方向電圧2V×10mA=20mW。回路全体では電源電圧10Vがそのまま掛かるので,10V×10mA=100mW である。したがって割合は 20mW÷100mW=20%となり,答はア。抵抗側の電圧は 10−2=8V なので,抵抗の消費電力は 8V×10mA=80mW で,これと LED の20mWを足すと全体の100mWに一致する。ウの80%は,この抵抗側の割合を答えてしまった値である。イの25%は,LEDの2Vを抵抗の8Vと比べて 2÷8 としたときに出る値で,分母が全体になっていない。エの100%は,抵抗での消費を無視した場合の値だが,問題文で無視してよいとされているのは電源の消費電力だけである。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問20
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問122.組込みシステムのプログラムで,放された状態では0になり,押された状態では1になるスイッチの値を読み込んでいる。このプログラムによって,スイッチの値は周期的に適切なタイミングで読み込まれ,チャタリング処理などの適切な処理が行われるものとし,a が今回の値で,b が前回の値とする。このスイッチが放された状態から押された状態に変化したことを検出するための論理式はどれか。ここで,“・”は論理積,“+”は論理和,“ ̄”は論理否定を表す。
- ア.a・b̄
- イ.ā・b
- ウ.a+b̄
- エ.ā+b
正解:ア.a・b̄
解説:「放された状態から押された状態に変化した」とは,前回が放されている(b=0)で,今回が押されている(a=1)ということである。b=0 を式で表すと b̄=1 なので,両方が同時に成り立つ条件は a・b̄ となり,答はア。イの ā・b は逆に「前回は押されていて今回は放された」,つまり離した瞬間を検出する式である。ウとエは論理和なので,どちらか一方が成り立つだけで1になってしまい,押しっぱなしや放しっぱなしの状態でも検出してしまう。この a・b̄ は立ち上がりエッジの検出と呼ばれ,押し続けている間ではなく押した瞬間だけを1回検出したいときの定番の書き方である。前回値を保存しておく変数が要る点も組込みでは重要になる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問21
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
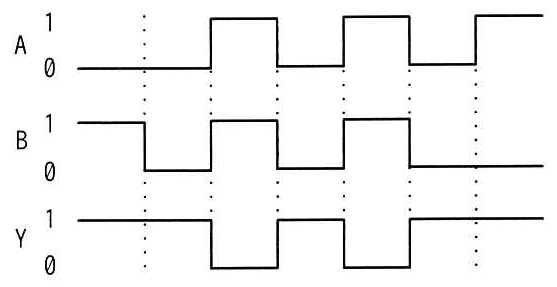
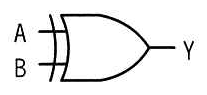
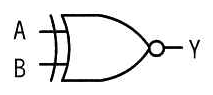
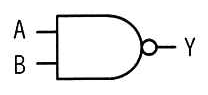
問123.入力が A と B,出力が Y の論理回路を動作させたとき,図のタイミングチャートが得られた。この論理回路として,適切なものはどれか。
- ア.
- イ.
- ウ.
- エ.
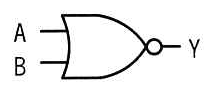
正解:ウ.
解説:タイミングチャートから,A と B の組合せごとに Y がどうなるかを読み取る。A=0・B=1 のとき Y=1,A=0・B=0 のとき Y=1,A=1・B=1 のとき Y=0,A=1・B=0 のとき Y=1 である。つまり両方が1のときだけ0になり,それ以外は1になっている。これは論理積を否定した NAND の動作なので,答はウ。アの XOR(排他的論理和)なら A=0・B=0 のとき0になるはずだが,チャートでは1なので合わない。イの XNOR なら A=0・B=1 のとき0になるはずで,これも合わない。エの NOR は A=0・B=0 のときだけ1になる回路なので,A=1・B=0 で1になっている点と矛盾する。図記号では,先端の小さな丸が否定を表し,入力側の線が曲線で二重になっているものが排他的論理和系である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問22
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問124.16ビットのダウンカウンターを用い,カウンターの値が0になると割込みを発生するハードウェアタイマーがある。カウンターに初期値として10進数の150をセットしてタイマーをスタートすると,最初の割込みが発生するまでの時間は何マイクロ秒か。ここで,タイマーの入力クロック周波数は16MHz を32分周したものとする。
- ア.0.3
- イ.2
- ウ.150
- エ.300
正解:エ.300
解説:まずタイマーに実際に入るクロックの周波数を求める。16MHz を32分周するので 16,000,000÷32=500,000Hz=500kHz である。1カウントに要する時間はその逆数で 1÷500,000=2マイクロ秒。ダウンカウンターは初期値150から1ずつ減って0になったときに割り込むので,150カウント分の時間がかかる。したがって 2μs×150=300マイクロ秒となり,答はエ。イの2は1カウントあたりの時間そのもので,150倍するのを忘れた値。ウの150はカウント数をそのまま時間と読んだ値である。アの0.3は,分周を掛け算と取り違えて 16MHz×32 として計算した場合などに出る桁違いの値。16ビットのカウンターなので最大65,535までセットでき,この設定では最長約131ミリ秒まで測れる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問23
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問125.画面サイズの制約によって,レイアウト上,常にメニューを表示しておくことが難しいときに使用する仕組みであって,三本線のアイコンを選択するとメニューが表示されるものはどれか。
- ア.アコーディオンメニュー
- イ.ドロップダウンメニュー
- ウ.ハンバーガーメニュー
- エ.ポップアップメニュー
正解:ウ.ハンバーガーメニュー
解説:三本の横線を重ねたアイコンは,その形がハンバーガーに似ていることからハンバーガーメニューと呼ばれる。ふだんはメニューを隠しておき,このアイコンを押したときだけ表示する仕組みで,画面の狭いスマートフォンで広く使われている。よって答はウ。アのアコーディオンメニューは,見出しを押すとその下の項目が折りたたみ/展開される形式で,楽器のアコーディオンの動きに例えたものである。イのドロップダウンメニューは,項目を選ぶと下方向にリストが垂れ下がる形式。エのポップアップメニューは,操作した位置に重ねて小さなメニューを出す形式で,右クリックで出るメニューが代表例である。いずれもメニューを隠す点は似ているが,三本線のアイコンを目印にするのはハンバーガーメニューだけである。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問24
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問126.0kHz〜20kHz の帯域幅のオーディオ信号をデジタル信号に変換するのに必要な最大のサンプリング周期を標本化定理によって求めると,何マイクロ秒か。
- ア.2.5
- イ.5
- ウ.25
- エ.50
正解:ウ.25
解説:標本化定理は,元の信号に含まれる最も高い周波数の2倍より高い周波数で標本化すれば,元の波形を復元できるというものである。この信号の最高周波数は20kHz なので,必要なサンプリング周波数は 2×20kHz=40kHz。周期はその逆数だから 1÷40,000=0.000025秒=25マイクロ秒となり,これが許される最大のサンプリング周期である。答はウ。エの50は,2倍するのを忘れて 20kHz の逆数をそのまま取った値(1÷20,000=50マイクロ秒)である。イの5とアの2.5は,さらに桁の扱いを誤った値である。サンプリング周期が長すぎる(周波数が低すぎる)と,元になかった低い周波数が現れる折返し雑音(エイリアシング)が生じる。CD の44.1kHz が20kHz 前後の可聴域をカバーできるのも,この定理に沿った設定である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問25
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問127.ソフトウェアの要件定義における利用者の分析で活用される,ソフトウェアの利用者を役割ごとに典型的な姿として描いた仮想の人物を何と呼ぶか。
- ア.エピック
- イ.ステークホルダ
- ウ.プロダクトオーナー
- エ.ペルソナ
正解:エ.ペルソナ
解説:ペルソナは,想定する利用者を「35歳・営業職・移動中にスマートフォンで確認する」といった具体的な人物像としてまとめたものである。抽象的な「利用者一般」ではなく特定の人物として描くことで,開発するメンバーの間で利用者像がぶれず,機能の優先順位を判断しやすくなる。よって答はエ。アのエピックはアジャイル開発で使う言葉で,大きなまとまりの要求を指し,分割して個々のユーザーストーリーにする。イのステークホルダは利害関係者のことで,利用者だけでなく発注者・運用者・監査部門なども含む実在の関係者である。ウのプロダクトオーナーはスクラムの役割の一つで,何を作るかの優先順位に責任をもつ実在の担当者である。仮想の人物像はペルソナだけである。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問46
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問128.UML のダイアグラムのうち,インスタンス間の関係を表現するものはどれか。
- ア.アクティビティ図
- イ.オブジェクト図
- ウ.コンポーネント図
- エ.ユースケース図
正解:イ.オブジェクト図
解説:オブジェクト図は,ある時点で実際に存在しているオブジェクト(インスタンス)と,その間のつながりを描く図である。クラス図が「型どうしの関係」を表すのに対し,オブジェクト図は「実物どうしの関係」を表し,クラス図だけでは分かりにくい具体的な状態の例を示すのに使う。よって答はイ。アのアクティビティ図は処理の流れや分岐・並行を表す図で,構造ではなく振る舞いを描く。ウのコンポーネント図は,実装上のまとまり(部品)とその依存関係を表す図である。エのユースケース図は,利用者(アクター)とシステムが提供する機能の関係を表し,要件を外から見た形で整理するものである。UML の図は構造を表すものと振る舞いを表すものに大別され,オブジェクト図とコンポーネント図が構造側にあたる。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問47
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問129.エラー埋込み法を用いて残存エラー数を推定する。当初の埋込みエラーは48個である。テスト期間中に発見されたエラーの内訳は,埋込みエラーが36個,真のエラーが42個である。このとき,残存する真のエラーは何個と推定されるか。
- ア.6
- イ.14
- ウ.54
- エ.56
正解:イ.14
解説:エラー埋込み法は,あらかじめ数の分かっている誤りをプログラムに仕込んでおき,テストでそのうち何割を見つけられたかを「テストの発見力」とみなす方法である。埋込みエラーは48個中36個見つかったので発見率は 36÷48=0.75。真のエラーも同じ割合で見つかったと仮定すると,発見した42個が全体の75%にあたるので,真のエラーの総数は 42÷0.75=56個と推定される。残っているのはそこから発見済みを引いた 56−42=14個で,答はイ。エの56は総数そのもので,引き算を忘れた値である。アの6は,発見した真のエラー42個と埋込みエラー36個の差で,比を使わずに引き算しただけの値である。ウの54は,埋込みエラーの残り(48−36=12個)に発見済みの真のエラー42個を足した値で,12+42=54 となる。いずれも「発見率で割り戻す」という手順を踏んでいない。この方法は「埋込みエラーと真のエラーが同じ見つかりやすさである」という仮定の上に成り立つ点に注意する。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問48
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問130.Web アプリケーションソフトウェアの処理方式の説明のうち,“プログレッシブ Web アプリ”の説明として,適切なものはどれか。
- ア.Web サーバ上に実行可能なプログラムを用意し,Web ブラウザからの要求に応じて,Web サーバがそのプログラムを呼び出し,処理結果を Web ブラウザに送信する。
- イ.Web ページの要素にその意味を表すメタデータを付加することによって,コンピュータが自動的に Web ページの情報の収集や加工を行えるようにする。
- ウ.新しい Web サービスを,他のサービスが公開する WebAPI の機能を組み合わせることによって提供する。
- エ.ブラウザが実行するサービスワーカーの機能を用いて,Web アプリケーションをオフラインで起動させたり,バックグラウンドでデータを同期させたりして,ネイティブアプリケーションであるかのように Web アプリケーションを使えるようにする。
正解:エ.ブラウザが実行するサービスワーカーの機能を用いて,Web アプリケーションをオフラインで起動させたり,バックグラウンドでデータを同期させたりして,ネイティブアプリケーションであるかのように Web アプリケーションを使えるようにする。
解説:プログレッシブWebアプリ(PWA)は,ブラウザで動くWebアプリを,端末にインストールしたアプリのように扱えるようにする仕組みである。中心になるのがサービスワーカーで,ページとは別に常駐して通信を横取りし,内容を手元に保存しておくことでオフラインでも起動でき,通信が回復したときにバックグラウンドで同期できる。ホーム画面への追加やプッシュ通知も可能になる。よって答はエ。アはサーバ側でプログラムを動かす従来のサーバサイド処理(CGIなど)の説明。イはセマンティックWebの説明で,機械が意味を解釈できるようメタデータを付ける考え方である。ウはマッシュアップの説明で,複数のWebAPIを組み合わせて新しいサービスを作る方式である。
出典:情報処理推進機構「令和7年度秋期 応用情報技術者試験 午前問題」問49
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問131.複数の袋からそれぞれ白と赤の玉を幾つかずつ取り出すとき,ベイズの定理を利用して事後確率を求める場合はどれか。
- ア.ある袋から取り出した二つの玉の色が同じと推定することができる確率を求める場合
- イ.異なる袋から取り出した玉が同じ色であると推定することができる確率を求める場合
- ウ.玉を一つ取り出すために,ある袋が選ばれると推定することができる確率を求める場合
- エ.取り出した玉の色から,どの袋から取り出されたのかを推定するための確率を求める場合
正解:エ.取り出した玉の色から,どの袋から取り出されたのかを推定するための確率を求める場合
解説:ベイズの定理は,結果を観測したうえで「その結果をもたらした原因が何であったか」の確率を求めるための道具である。式は P(原因|結果)=P(結果|原因)×P(原因)/P(結果) で,あらかじめ分かっている原因の確率(事前確率)を,観測された結果によって更新した値(事後確率)が得られる。この問題では,袋が原因,取り出した玉の色が結果に当たるので,「取り出した玉の色から,どの袋から取り出されたのかを推定するための確率」を求める場合が事後確率の計算になり,答はエ。アは同じ袋から2個取り出したときに色がそろう確率で,袋が分かっている状態から結果の確率を求めているので事前の情報だけで計算できる(原因から結果へ向かう向き)。イも,袋が指定された状態で色が一致する確率を求めるもので,向きは同じである。ウの「玉を一つ取り出すために,ある袋が選ばれる確率」は,結果を観測する前の袋の選ばれやすさそのもので,これが事前確率に当たる。原因から結果へ向かうのが尤度,結果から原因へ遡るのが事後確率という向きの違いが,この設問の要点である。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問1
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問132.ATM(現金自動預払機)が1台ずつ設置してある二つの支店を統合し,統合後の支店には ATM を1台設置する。統合後の ATM の平均待ち時間を求める式はどれか。ここで,待ち時間は M/M/1 の待ち行列モデルに従い,平均待ち時間にはサービス時間を含まず,ATM を1台に統合しても十分に処理できるものとする。 〔条件〕 (1) 統合後の平均サービス時間:Ts (2) 統合前の ATM の利用率:両支店とも ρ (3) 統合後の利用者数:統合前の両支店の利用者数の合計
- ア.ρ/(1-ρ)×Ts
- イ.ρ/(1-2ρ)×Ts
- ウ.2ρ/(1-ρ)×Ts
- エ.2ρ/(1-2ρ)×Ts
正解:エ.2ρ/(1-2ρ)×Ts
解説:M/M/1 の平均待ち時間はサービス時間を含めない形で Tw=ρ/(1-ρ)×Ts と表され,ρ は利用率である。したがってこの問題は「統合後の利用率がいくらになるか」を求めれば答えが出る。利用率は「単位時間当たりの到着数×平均サービス時間」で決まる。統合によって利用者数は両支店の合計になるので到着数は2倍になり,平均サービス時間は変わらないので,統合後の利用率は 2ρ になる。これを式に入れると 2ρ/(1-2ρ)×Ts となり,答はエ。ウは分子だけを2倍にして分母の利用率を ρ のままにしたもので,利用率が上がると待ち時間が急に増えるという効果を取り込めていない。アは統合前の1支店の式そのままで,利用者が増えたことを反映していない。イは分母だけを 1-2ρ にして分子を ρ のままにしたものである。なお,この式は分母が正である必要があるので ρ<0.5 が前提で,設問の「1台に統合しても十分に処理できる」という条件がそれを担保している。統合前の利用率が0.4なら統合後は0.8となり,待ち時間はサービス時間の4倍まで伸びる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問2
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問133.AI におけるディープラーニングに関する記述として,最も適切なものはどれか。
- ア.あるデータから結果を求める処理を,人間の脳神経回路のように多層の処理を重ねることによって,複雑な判断をできるようにする。
- イ.大量のデータからまだ知られていない新たな規則や仮説を発見するために,想定値から大きく外れている例外事項を取り除きながら分析を繰り返す手法である。
- ウ.多様なデータや大量のデータに対して,三段論法,統計的手法やパターン認識手法を組み合わせることによって,高度なデータ分析を行う手法である。
- エ.知識がルールに従って表現されており,演繹手法を利用した推論によって有意な結論を導く手法である。
正解:ア.あるデータから結果を求める処理を,人間の脳神経回路のように多層の処理を重ねることによって,複雑な判断をできるようにする。
解説:ディープラーニング(深層学習)は,人間の脳神経回路を模したニューラルネットワークの中間層を多数重ねることで,入力から結果を導く過程を段階的に処理する手法である。層を深くすることで,画素の並びから輪郭,輪郭から部品,部品から物体といったように,人が設計しなくても特徴を段階的に自動で獲得できるようになり,画像認識・音声認識・自然言語処理で飛躍的な精度向上をもたらした。したがって答はア。イは,データから未知の規則や仮説を掘り出すデータマイニングの説明に近く,「例外を取り除きながら分析を繰り返す」という手続きはディープラーニングの本質ではない。ウは,統計的手法やパターン認識を組み合わせた高度なデータ分析全般の説明で,ディープラーニングもその一手法ではあるが,「三段論法」を含むこの記述は特定の手法の定義にはなっていない。エは,あらかじめ人が与えたルールから演繹によって結論を導くエキスパートシステム(ルールベースの推論)の説明で,データから自ら特徴を学ぶディープラーニングとは考え方が逆である。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問3
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問134.符号長7ビット,情報ビット数4ビットのハミング符号による誤り訂正の方法を,次のとおりとする。 受信した7ビットの符号語 x₁ x₂ x₃ x₄ x₅ x₆ x₇(xₖ=0 又は 1)に対して c₀ = x₁ +x₃ +x₅ +x₇ c₁ = x₂+x₃ +x₆+x₇ c₂ = x₄+x₅+x₆+x₇ (いずれも mod 2 での計算) を計算し,c₀,c₁,c₂ の中に少なくとも一つは0でないものがある場合には, i = c₀+c₁×2+c₂×4 を求めて,左から i ビット目を反転することによって誤りを訂正する。 受信した符号語が 1000101 であった場合,誤り訂正後の符号語はどれか。
- ア.1000001
- イ.1000101
- ウ.1001101
- エ.1010101
正解:エ.1010101
解説:受信した符号語 1000101 を左から順に当てはめると x₁=1,x₂=0,x₃=0,x₄=0,x₅=1,x₆=0,x₇=1 である。定義に従って計算すると,c₀=x₁+x₃+x₅+x₇=1+0+1+1=3 で mod 2 を取ると1,c₁=x₂+x₃+x₆+x₇=0+0+0+1=1,c₂=x₄+x₅+x₆+x₇=0+1+0+1=2 で mod 2 を取ると0 になる。0でないものがあるので i=c₀+c₁×2+c₂×4=1+2+0=3 を求め,左から3ビット目を反転する。3ビット目は0なので1に変わり,訂正後の符号語は 1010101 となる。答はエ。この方式は,3つの検査式の結果を2進数の各桁とみなすことで誤りの位置をそのまま指し示す仕組みになっており,1ビットの誤りであれば必ず位置を特定して直せる。イの1000101 は受信したままの値で,訂正が不要だった場合の答えである。アの1000001 は5ビット目を反転した場合,ウの1001101 は4ビット目を反転した場合の値で,i の計算で c₁×2 と c₂×4 の重みを取り違えると出てくる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問4
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問135.正の整数 M に対して,次の二つの流れ図に示すアルゴリズムを実行したとき,結果 x の値が等しくなるようにしたい。a に入れる条件として,適切なものはどれか。
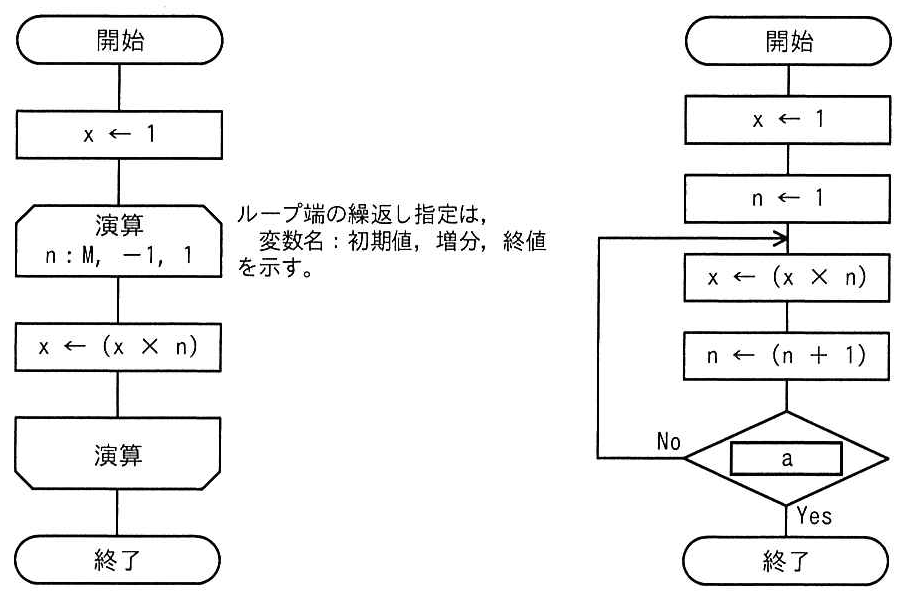
- ア.n<M
- イ.n>M-1
- ウ.n>M
- エ.n>M+1
正解:ウ.n>M
解説:左の流れ図は,x を1にしてから,ループ端の指定「n:M,-1,1」に従って n を M から1まで1ずつ減らしながら x←x×n を繰り返す。したがって x=M×(M-1)×…×1=M! になる。右の流れ図は,x←1,n←1 としてから,x←x×n,n←n+1 を実行し,そのあとで条件 a を判定して Yes なら終了,No ならループの先頭へ戻る後判定型の繰返しである。k 回目の繰返しを終えた時点で x=k!,n=k+1 になる。x=M! で終わらせたいので,M 回目を終えた時点(n=M+1)で初めて条件が真になり,それ以前(n≦M)では偽である必要がある。この条件は n>M で,答はウ。イの n>M-1 は n=M の時点,すなわち M-1 回目を終えた時点で真になるので x=(M-1)! で止まってしまう。エの n>M+1 は n=M+2 まで真にならないので1回多く回り x=(M+1)! になる。アの n<M は,M が3以上のとき1回目を終えた時点(n=2)で偽ではなく真であり,判定の向きが逆で意図した回数だけ回らない。後判定型の繰返しでは,判定の時点で n が「次に使う値」まで進んでいることに注意が必要である。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問5
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問136.各ノードがもつデータを出力する再帰処理 f(ノード n)を定義した。この処理を,図の2分木の根(最上位のノード)から始めたときの出力はどれか。 〔f(ノード n)の定義〕 1. ノード n の右に子ノード r があれば,f(ノード r)を実行 2. ノード n の左に子ノード l があれば,f(ノード l)を実行 3. 再帰処理 f(ノード r),f(ノード l)を未実行の子ノード,又は子ノードがなければ,ノード自身がもつデータを出力 4. 終了
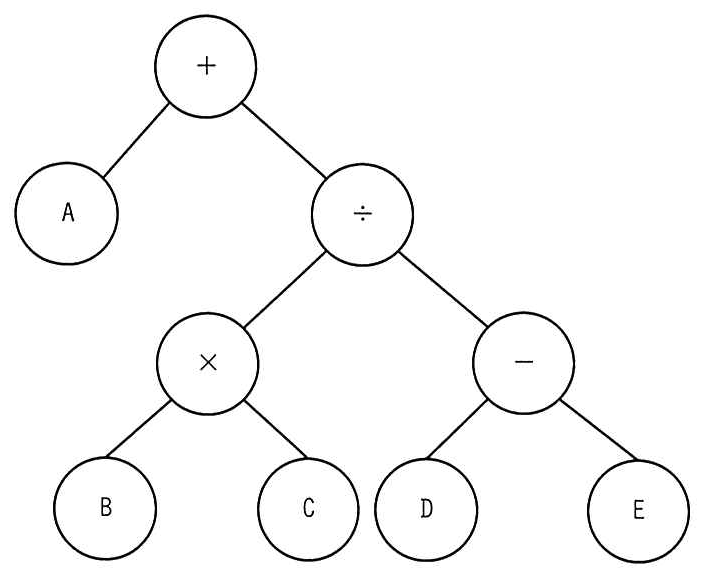
- ア.+÷-ED×CBA
- イ.ABC×DE-÷+
- ウ.E-D÷C×B+A
- エ.ED-CB×÷A+
正解:エ.ED-CB×÷A+
解説:定義は「右の子を処理→左の子を処理→自分を出力」の順なので,後順走査(帰りがけ順)の左右を入れ替えた形になる。根の+から追う。+の右の子は÷なので f(÷) へ入る。÷の右の子は-なので f(-) へ入り,-の右の子 E は子をもたないので E を出力,次に左の子 D を出力し,最後に-自身を出力する(ここまで E D -)。÷に戻って左の子×へ入り,×の右の子 C を出力,左の子 B を出力,×自身を出力する(C B ×)。÷自身を出力し(÷),+に戻って左の子 A を出力し(A),最後に+自身を出力する(+)。つないで ED-CB×÷A+ となり,答はエ。イの ABC×DE-÷+ は,左の子を先に処理する通常の後順走査(つまり逆ポーランド表記)の結果で,定義の1と2が入れ替わっている。アの+÷-ED×CBA は自分を先に出力する先行順走査で右を先に見た形,ウの E-D÷C×B+A は左右の子を挟んで自分を出力する中間順走査を右から見た形であり,いずれも出力の位置が定義と合わない。3つの走査(先行順・中間順・後順)のうち,自分をいつ出力するかで見分けるのが確実である。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問6
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問137.整列方法に関するアルゴリズムの記述のうち,バブルソートの記述はどれか。ここで,整列対象は重複のない1から9の数字がランダムに並んでいる数字列とする。
- ア.数字列の最後の数字から最初の数字に向かって,隣り合う二つの数字を比較して小さい数字が前に来るよう数字を入れ替える操作を繰り返し行う。
- イ.数字列の中からランダムに基準となる数を選び,基準より小さい数と大きい数の二つのグループに分け,それぞれのグループ内も同じ操作を繰り返し行う。
- ウ.数字列をほぼ同じ長さの二つの数字列のグループに分割していき,分割できなくなった時点から,グループ内で数字が小さい順に並べる操作を繰り返し行う。
- エ.未処理の数字列の中から最小値を探索し,未処理の数字列の最初の数字と入れ替える操作を繰り返し行う。
正解:ア.数字列の最後の数字から最初の数字に向かって,隣り合う二つの数字を比較して小さい数字が前に来るよう数字を入れ替える操作を繰り返し行う。
解説:バブルソート(隣接交換法)は,隣り合う要素を比較して順序が逆なら入れ替える操作を,端から端まで繰り返す方法である。この操作を1往復させるごとに最小(または最大)の要素が端まで移動していく様子が泡が浮かぶように見えることから,この名前が付いた。アがこの記述に当たるので答はア。比較の回数は要素数 n に対して n(n-1)/2 程度で,計算量は O(n²) である。イは,基準となる値(ピボット)を選んで小さい組と大きい組に分け,それぞれに同じ操作を再帰的に適用するクイックソートの説明で,平均の計算量は O(n log n) と速いが,偏った分割が続くと O(n²) に落ちる。ウは,ほぼ半分ずつに分割してから小さい単位で並べ直し,整列済みの列を統合していくマージソートの説明で,計算量は常に O(n log n) だが作業用の領域を必要とする。エは,未処理の範囲から最小値を探して先頭と交換する選択ソートの説明で,比較回数はバブルソートと同じ O(n²) だが交換回数が少なくて済む。バブルソートは「隣どうしの交換」,選択ソートは「最小値を探して1回交換」という違いで見分けられる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問7
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問138.同一メモリ空間で,転送元の開始アドレス,転送先の開始アドレス,方向フラグ及び転送語数をパラメータとして指定することによって,データをブロック転送できる機能をもつ CPU がある。図のようにアドレス 1001 から 1004 のデータをアドレス 1003 から 1006 に転送するとき,指定するパラメータとして適切なものはどれか。ここで,転送は開始アドレスから1語ずつ行われ,方向フラグに0を指定するとアドレスの昇順に,1を指定するとアドレスの降順に転送を行うものとする。
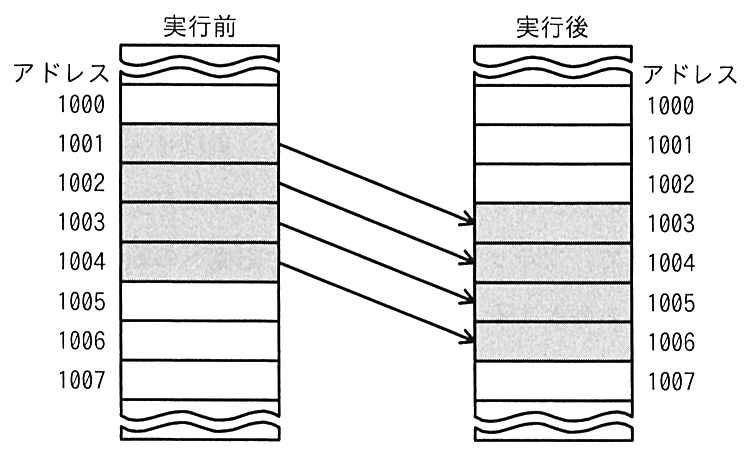
- ア.転送元 1001/転送先 1003/方向フラグ 0/転送語数 4
- イ.転送元 1001/転送先 1003/方向フラグ 1/転送語数 4
- ウ.転送元 1004/転送先 1006/方向フラグ 0/転送語数 4
- エ.転送元 1004/転送先 1006/方向フラグ 1/転送語数 4
正解:エ.転送元 1004/転送先 1006/方向フラグ 1/転送語数 4
解説:転送元 1001〜1004 と転送先 1003〜1006 は 1003 と 1004 の2語が重なっている。同じメモリ空間なので,まだ読んでいない語を先に上書きしてしまうと元のデータが失われる。アのように 1001 から昇順に転送すると,1語目で 1001→1003,2語目で 1002→1004 と書き込んだ時点で元の 1003 と 1004 が壊れ,3語目に 1003 を読もうとしたときには先ほど書いた値(元の 1001)が入っているので誤った結果になる。これを避けるには,重なりの向きに合わせて後ろから転送すればよい。転送先が転送元より高いアドレスにあるので,末尾の 1004→1006 から始めて降順に 1003→1005,1002→1004,1001→1003 と進めれば,読む前に上書きされる語は生じない。したがって転送元の開始アドレス 1004,転送先の開始アドレス 1006,方向フラグ1(降順),転送語数4となり答はエ。ウは同じ末尾から始めているが方向フラグが0(昇順)なので,1004→1006 の次に 1005→1007 と範囲の外へ進んでしまう。イは開始アドレスが先頭のまま降順を指定しており,1001→1003 の次に 1000→1002 と手前へ進むので転送すべき範囲を外れる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問8
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問139.量子ゲート方式の量子コンピュータの説明として,適切なものはどれか。
- ア.演算は2進数で行われ,結果も2進数で出力される。
- イ.特定のアルゴリズムによる演算だけができ,加算演算はできない。
- ウ.複数の状態を同時に表現する量子ビットと,その重ね合わせを利用する。
- エ.量子状態を変化させながら観測するので,100℃以上の高温で動作する。
正解:ウ.複数の状態を同時に表現する量子ビットと,その重ね合わせを利用する。
解説:量子ゲート方式の量子コンピュータは,0と1の両方の状態を同時に取り得る量子ビット(キュービット)を用い,重ね合わせと量子もつれを利用して,量子ゲートによる演算を組み合わせて計算を行う。古典的なコンピュータのビットが必ず0か1のどちらかであるのに対し,n 個の量子ビットは 2ⁿ 通りの状態を同時に扱えるため,特定の問題で飛躍的な高速化が期待できる。したがって答はウ。アは,量子ビットは0と1の重ね合わせを取るので演算の途中は2進数として確定しておらず,記述が当てはまらない(観測すると0か1に定まるが,それは計算の途中の状態を表していない)。イは,量子ゲート方式は任意の量子回路を組める汎用型で,加算を含む一般の演算を実現できる。特定の問題(組合せ最適化)に特化しているのは量子アニーリング方式のほうで,こちらは量子ゲート方式と対になるもう一つの方式である。エは向きが逆で,量子状態は熱や電磁波の影響でごく短時間に崩れてしまう(デコヒーレンス)ため,多くの実装では絶対零度に近い極低温に冷やして動作させる。100℃以上の高温という記述は誤りである。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問9
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問140.主記憶のアクセス時間が60ナノ秒,キャッシュメモリのアクセス時間が10ナノ秒であるシステムがある。キャッシュメモリを介して主記憶にアクセスする場合の実効アクセス時間が15ナノ秒であるとき,キャッシュメモリのヒット率は幾らか。
- ア.0.1
- イ.0.17
- ウ.0.83
- エ.0.9
正解:エ.0.9
解説:ヒット率を h とすると,実効アクセス時間は「h×キャッシュのアクセス時間+(1-h)×主記憶のアクセス時間」で表せる。数値を入れると 10h+60(1-h)=15 となり,10h+60-60h=15,-50h=-45 から h=0.9 が得られる。したがって答はエ。検算すると 0.9×10+0.1×60=9+6=15 で条件に合う。アの0.1は 1-0.9 で,ヒット率ではなくミス率に当たる。イの0.17は 10÷60=0.167 に一致し,キャッシュと主記憶のアクセス時間の比をそのままヒット率と取り違えた場合の値である。ウの0.83は 50÷60=0.833 に一致し,1-0.167 すなわちイの補数に当たる。この式で押さえておきたいのは,実効アクセス時間の15ナノ秒はキャッシュの10ナノ秒に近い値であり,ヒット率が高いほど実効値はキャッシュ側に寄るという関係である。仮にヒット率が0.5なら 0.5×10+0.5×60=35ナノ秒となり,15ナノ秒を実現するにはかなり高いヒット率が必要だと見当が付く。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問10
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問141.15Mバイトのプログラムを圧縮して,フラッシュメモリに格納している。プログラムのサイズは圧縮によって元のサイズの40%になっている。フラッシュメモリから主記憶への転送速度が20Mバイト/秒であり,1Mバイトに圧縮されたデータの展開に主記憶上で0.03秒が掛かるとき,このプログラムが主記憶に展開されるまでの時間は何秒か。ここで,フラッシュメモリから主記憶への転送と圧縮データの展開は同時には行われないものとする。
- ア.0.48
- イ.0.75
- ウ.0.93
- エ.1.20
正解:ア.0.48
解説:まず圧縮後のサイズを求める。15Mバイトの40%なので 15×0.4=6Mバイトである。転送はこの圧縮された6Mバイトを運ぶので 6÷20=0.3秒。展開の所要時間は「1Mバイトに圧縮されたデータあたり0.03秒」なので,圧縮後の6Mバイトに対して 6×0.03=0.18秒である。両者は同時に行われないので合計は 0.3+0.18=0.48秒となり,答はア。イの0.75は 0.3+15×0.03=0.3+0.45 に一致し,展開の時間を圧縮前のサイズ15Mバイトで計算した場合の値である。ウの0.93は 15÷20+6×0.03=0.75+0.18 に一致し,転送するサイズを圧縮前の15Mバイトと取り違えた場合の値になる。エの1.20は 15÷20+15×0.03=0.75+0.45 に一致し,転送も展開もどちらも圧縮前のサイズで計算した場合の値である。要点は,フラッシュメモリに入っているのも転送されるのも圧縮された状態のデータであり,展開の所要時間の基準も「圧縮されたデータ1Mバイト当たり」と書かれている点で,どちらも圧縮後の6Mバイトを使うことである。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問11
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問142.システムの信頼性設計に関する記述のうち,適切なものはどれか。
- ア.フェールセーフとは,利用者の誤操作によってシステムが異常終了してしまうことのないように,単純なミスを発生させないようにする設計方法である。
- イ.フェールソフトとは,故障が発生した場合でも機能を縮退させることなく稼働を継続する概念である。
- ウ.フォールトアボイダンスとは,システム構成要素の個々の品質を高めて故障が発生しないようにする概念である。
- エ.フォールトトレランスとは,故障が生じてもシステムに重大な影響が出ないように,あらかじめ定められた安全状態にシステムを固定し,全体として安全が維持されるような設計方法である。
正解:ウ.フォールトアボイダンスとは,システム構成要素の個々の品質を高めて故障が発生しないようにする概念である。
解説:信頼性設計の考え方は,故障を起こさないようにする方向と,故障が起きても被害を抑える方向に大きく分かれる。フォールトアボイダンス(障害回避)は前者で,部品や工程の品質を高め,設計を単純にして,そもそも故障が起きないようにする概念である。ウがこれに当たるので答はウ。後者はフォールトトレランス(耐障害性)で,冗長化などによって故障が起きても機能を保つ考え方であり,その実現方法にフェールセーフとフェールソフトがある。エはフェールセーフの説明を「フォールトトレランス」に当てており誤りである。フェールセーフは,故障したら安全な側で停止させる方法(信号機を赤にする,ガスを止めるなど)である。イは,フェールソフトは機能を落として(縮退させて)でも稼働を続ける方法なので,「縮退させることなく」が誤りである。縮退運転そのものがフェールソフトの中身である。アはフールプルーフの説明で,利用者が誤った操作をしても危険や異常終了に至らないようにする設計方法である。4つの用語は「起こさない(アボイダンス)」「起きても耐える(トレランス=フェールセーフ/フェールソフト)」「人の誤りに備える(フールプルーフ)」と整理すると取り違えにくい。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問12
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問143.オブジェクトストレージの記述として,最も適切なものはどれか。
- ア.更新頻度の少ない非構造型データの格納に適しており,大容量で拡張性のあるストレージ空間を仮想的に実現することができる。
- イ.高速のストレージ専用ネットワークを介して,複数のサーバからストレージを共有することによって,高速にデータを格納することができる。
- ウ.サーバごとに割り当てられた専用ストレージであり,容量が不足したときにはストレージを追加することができる。
- エ.複数のストレージを組み合わせることによって,仮想的な1台のストレージとして運用することができる。
正解:ア.更新頻度の少ない非構造型データの格納に適しており,大容量で拡張性のあるストレージ空間を仮想的に実現することができる。
解説:オブジェクトストレージは,データ本体とメタデータを一意の識別子と組にして格納する方式で,名前空間が階層をもたないフラットな構造のため,台数を増やすだけで容量と性能を伸ばせる。一部だけを書き換える上書き更新には向かず,オブジェクト全体を置き換える形になるので,画像・動画・ログ・バックアップのように書いたあとあまり更新しない非構造型データの保管に適している。したがって答はア。イは SAN(ストレージエリアネットワーク)の説明で,ファイバチャネルなどの専用ネットワークを介してブロック単位でストレージを共有する方式である。ウは DAS(Direct Attached Storage)の説明で,サーバに直接つないだ専用のストレージを指す。エはストレージ仮想化(あるいは RAID による束ね)の説明で,複数の装置を1台に見せる技術である。オブジェクトストレージも複数の装置に分散して置かれるが,本質は「識別子でアクセスするフラットな空間」であって,1台に見せることが目的ではない。クラウドの大容量ストレージサービスが代表例で,安価な装置を並べて巨大な空間を作れる点が価値になっている。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問13
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問144.1台の CPU の性能を1とするとき,その CPU を n 台用いたマルチプロセッサの性能 P が, P=n/(1+(n-1)a) で表されるとする。ここで,a はオーバーヘッドを表す定数である。例えば,a=0.1,n=4 とすると,P≒3 なので,4台の CPU から成るマルチプロセッサの性能は約3になる。この式で表されるマルチプロセッサの性能には上限があり,n を幾ら大きくしても P はある値以上には大きくならない。a=0.1 の場合,P の上限は幾らか。
- ア.5
- イ.10
- ウ.15
- エ.20
正解:イ.10
解説:式の分母を展開すると 1+(n-1)a=1-a+an となるので P=n/(1-a+an) である。分母と分子を n で割ると P=1/((1-a)/n+a) となり,n を大きくすると (1-a)/n は0に近づくので P は 1/a に近づく。a=0.1 なので上限は 1÷0.1=10 となり,答はイ。具体的に計算すると,n=4 では 4÷(1+3×0.1)=4÷1.3≒3.08 で設問の例(約3)と一致し,n=10 では 10÷1.9≒5.3,n=100 では 100÷10.9≒9.2,n=1,000 では 1,000÷100.9≒9.9 と,確かに10に近づきながら超えない。台数を10倍にしても性能が2倍に届かないという伸び方であり,オーバーヘッドが並列化の効果を頭打ちにすることを示している。アの5は 1/(2a) に当たる値,ウの15とエの20は 1/a を超えた値で,どちらも n をいくら増やしても到達できない。この式はアムダールの法則と同じ形で,1/a が「並列化できない部分の逆数」に相当すると読める。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問14
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問145.コンピュータの性能評価には,シミュレーションを用いた方法,解析的な方法などがある。シミュレーションを用いた方法の特徴はどれか。
- ア.解析的な方法よりも計算量が少なく,効率的に解が求まる。
- イ.解析的な方法よりも,乱数を用いることで高精度の解が得られる。
- ウ.解析的に解が求められないモデルに対しても,数値的に解が求まる。
- エ.解析的に解が求められるモデルの検証には使用できない。
正解:ウ.解析的に解が求められないモデルに対しても,数値的に解が求まる。
解説:解析的な方法は,待ち行列理論のように数式を立てて答えを直接導く方法で,条件が理論の前提に合う範囲では速く正確に求まる。しかし現実のシステムは,到着や処理時間の分布が理論の前提から外れたり,複数の資源が絡み合ったりして数式に落とせないことが多い。シミュレーションは対象の動きを計算機上で模擬して統計を取る方法なので,数式では解けないモデルに対しても数値として答えを得られる。これが最大の特徴であり,答はウ。アは逆で,シミュレーションは何度も試行を繰り返して統計を取るため計算量は解析的な方法より多くなる。イも誤りで,乱数を使った試行の平均は誤差を含み,精度は試行回数に応じて(おおむね回数の平方根に反比例して)改善するにすぎない。解析的に解ける問題では,解析解のほうが精度は高い。エも誤りで,解析的に解が求められるモデルにシミュレーションを適用して両者を突き合わせることは,シミュレーションの模型やプログラムが正しいかを確かめる有効な検証手段になる。むしろ実務では,まず解ける問題で結果を照合してから未知の問題に適用するという手順が採られる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問15
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問146.ノンプリエンプティブ方式のタスクの状態遷移に関する記述として,適切なものはどれか。
- ア.OS は実行中のタスクの優先度を他のタスクよりも上げることによって,実行中のタスクが終了するまでタスクが切り替えられるのを防ぐ。
- イ.実行中のタスクが自らの中断を OS に要求することによってだけ,OS は実行中のタスクを中断し,動作可能な他のタスクを実行中に切り替えることができる。
- ウ.実行中のタスクが無限ループに陥っていることを OS が検知した場合,OS は実行中のタスクを終了させ,動作可能な他のタスクを実行中に切り替える。
- エ.実行中のタスクより優先度が高い動作可能なタスクが実行待ち行列に追加された場合,OS は実行中のタスクを中断し,優先度が高い動作可能なタスクを実行中に切り替える。
正解:イ.実行中のタスクが自らの中断を OS に要求することによってだけ,OS は実行中のタスクを中断し,動作可能な他のタスクを実行中に切り替えることができる。
解説:ノンプリエンプティブ方式は,OS が実行中のタスクから強制的に CPU を取り上げない方式である。タスクの切替えは,実行中のタスクが処理を終えるか,入出力待ちに入るか,自ら CPU を手放す要求(システムコール)を出したときにだけ起きる。したがって答はイ。制御の切替え点が限られるため実装が単純で,切替えに伴うオーバーヘッドも小さいが,1つのタスクが CPU を離さないと他のタスクがまったく動けなくなるという弱点がある。エはこれと対になるプリエンプティブ方式の説明で,優先度の高いタスクが実行可能になった時点で OS が実行中のタスクを中断させる。リアルタイム性が要求される場面ではこちらが必要になる。ウは,無限ループを OS が検知して打ち切るという内容だが,ノンプリエンプティブ方式では OS が強制的に介入しないので,まさにこの状態に陥るとシステム全体が止まってしまう。これがこの方式の最大の危険である。アは,優先度を上げて切替えを防ぐという説明だが,ノンプリエンプティブ方式ではそもそも優先度によって強制的に切り替えられることがないので,そのような操作は必要がない。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問16
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問147.三つの資源 X〜Z を占有して処理を行う四つのプロセス A〜D がある。各プロセスは処理の進行に伴い,表中の数値の順に資源を占有し,実行終了時に三つの資源を一括して解放する。プロセス A と同時にもう一つプロセスを動かした場合に,デッドロックを起こす可能性があるプロセスはどれか。 〔表〕資源の占有順序(プロセス/資源 X/資源 Y/資源 Z) A/1/2/3 B/1/2/3 C/2/3/1 D/3/2/1
- ア.B,C,D
- イ.C,D
- ウ.C だけ
- エ.D だけ
正解:イ.C,D
解説:表の数値は占有する順番なので,各プロセスが資源を取る順序に置き換えると,A は X→Y→Z,B も X→Y→Z,C は Z→X→Y,D は Z→Y→X となる。デッドロックは,2つのプロセスが資源を互いに逆の順序で要求し合ったときに起こり得る。A と B は取る順序が完全に同じなので,先に X を取れたほうが先に進み,もう一方は X の解放を待つだけで循環は生じない。A と C では,A が X を,C が Z を取った状態から,A は Z の解放を待ち,C は X の解放を待つので互いに待ち合う。A と D でも,A が X を,D が Z を取った状態から,A は Y と Z を,D は Y と X を必要とするため,Y をどちらが取っても最終的に互いの持つ資源を待つ形になる。したがってデッドロックの可能性があるのは C と D で,答はイ。アは B を含めており,同じ順序で取るプロセスの組では循環待ちが生じないという点を見落としている。ウとエはもう一方を見落としている。予防策としては,すべてのプロセスで資源を取る順序をそろえる(この例では X→Y→Z に統一する)ことが有効で,これは A と B の関係が示している。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問17
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問148.複数のクライアントから接続されるサーバがある。このサーバのタスクの多重度が2以下の場合,タスク処理時間は常に4秒である。このサーバに1秒間隔で4件の処理要求が到着した場合,全ての処理が終わるまでの時間はタスクの多重度が1のときと2のときとで,何秒の差があるか。
- ア.6
- イ.7
- ウ.8
- エ.9
正解:イ.7
解説:処理要求は0秒,1秒,2秒,3秒の時点に到着し,1件の処理には4秒掛かる。多重度が1のときは同時に1件しか処理できないので,1件目が0〜4秒,2件目が4〜8秒,3件目が8〜12秒,4件目が12〜16秒となり,すべて終わるのは16秒後である。多重度が2のときは同時に2件まで処理できる。1件目は0秒に到着して0〜4秒,2件目は1秒に到着して1〜5秒に処理される。2秒と3秒に到着した3件目・4件目は空きがないので待ち,1件目が終わる4秒に3件目が始まって4〜8秒,2件目が終わる5秒に4件目が始まって5〜9秒となり,すべて終わるのは9秒後である。差は 16-9=7秒で,答はイ。要点は,多重度2でも到着が1秒間隔なので3件目と4件目は待たされるという点と,待ちが解けるのは先の処理が終わる時刻だという点である。アの6秒,ウの8秒,エの9秒は,待ちの開始時刻を到着時刻のままにしたり,多重度1のときの16秒を別の値に取ったりした場合に出る。なお多重度2のときの9秒は「4件目の到着5秒後」ではなく「4件目が5秒に開始して4秒掛かる」ことから決まる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問18
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問149.プログラムを構成するモジュールや関数の実行回数,実行時間など,性能改善のための分析に役立つ情報を収集するツールはどれか。
- ア.エミュレーター
- イ.シミュレーター
- ウ.デバッガ
- エ.プロファイラ
正解:エ.プロファイラ
解説:プロファイラは,プログラムを実行しながら,どの関数が何回呼ばれたか,それぞれにどれだけ時間が掛かったか,メモリをどれだけ使ったかといった情報を集めるツールである。集めた情報から時間を多く消費している箇所(ホットスポット)を特定できるので,性能改善では「まず測る,次に直す」の測る側を担う。したがって答はエ。勘に頼って最適化すると,実際にはほとんど時間を使っていない箇所を作り込んでしまうことがあるため,プロファイラによる実測が重要になる。アのエミュレーターは,別のハードウェアや環境の動作を模擬して,本来その環境向けに作られたプログラムをそのまま動かせるようにするものである。イのシミュレーターは,対象の挙動を模型として計算し,動作や性能を予測するもので,実機がまだない段階の検討などに使う。ウのデバッガは,プログラムを止めながら変数の値や実行の流れを調べ,誤りの原因を突き止めるツールで,対象は「正しく動くか」であって「速く動くか」ではない。目的が性能の分析なのか,誤りの発見なのか,別環境での実行なのかで区別できる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問19
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問150.エアコンや電気自動車でエネルギー効率のよい制御や電力変換をするためにパワー半導体が用いられる。このパワー半導体の活用例の一つであるインバータの説明として,適切なものはどれか。
- ア.直流電圧をより高い直流電圧に変換する。
- イ.直流電圧をより低い直流電圧に変換する。
- ウ.交流電力を直流電力に変換する。
- エ.直流電力を交流電力に変換する。
正解:エ.直流電力を交流電力に変換する。
解説:インバータは直流電力を交流電力に変換する装置で,出力する交流の周波数と電圧を自在に変えられる点が特徴である。エアコンでは,圧縮機のモータの回転数を必要な冷暖房の能力に合わせて連続的に変えられるので,運転を入り切りして温度を保つ方式に比べて無駄が少なく,省エネルギーになる。電気自動車では,バッテリーの直流を交流に変えて走行用モータを駆動し,速度やトルクを制御する。したがって答はエ。ウは交流を直流に変換するコンバータ(整流器)の説明で,インバータと逆の働きをする。太陽光発電の電力を家庭の交流に変える装置はインバータ(パワーコンディショナ),家電のAC アダプタはコンバータに当たる。アは直流を高い直流に変える昇圧チョッパ,イは直流を低い直流に変える降圧チョッパの説明で,どちらも直流から直流への変換なのでインバータではない。いずれの装置もスイッチング素子を高速に入り切りして実現しており,そこで用いられる IGBT や MOSFET,近年では炭化ケイ素(SiC)や窒化ガリウム(GaN)の素子がパワー半導体である。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問20
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問151.入力が A と B,出力が Y の論理回路を動作させたとき,図のタイムチャートが得られた。この論理回路として,適切なものはどれか。
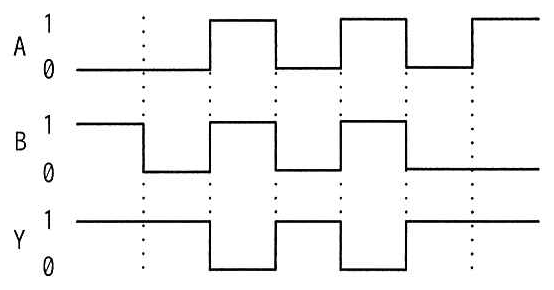
- ア.
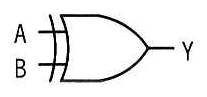
- イ.
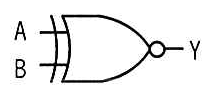
- ウ.
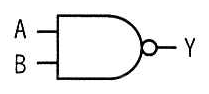
- エ.
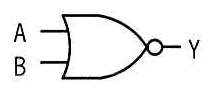
正解:ウ.
解説:タイムチャートから A と B の組合せごとに Y がどうなるかを読み取る。A=0・B=1 のとき Y=1,A=0・B=0 のとき Y=1,A=1・B=1 のとき Y=0,A=1・B=0 のとき Y=1 である。つまり両方が1のときだけ0になり,それ以外は1になっているので,これは論理積を否定した NAND の動作である。したがって答はウで,記号は AND の形(入力側が平ら)の出力に否定を表す小さな丸が付いたものになる。アは入力側の線が二重になった XOR(排他的論理和)で,A=0・B=0 のとき0になるはずだがチャートでは1なので合わない。イはその XOR に否定の丸が付いた XNOR で,A=0・B=1 のとき0になるはずだがチャートでは1なので合わない。エは OR の形(入力側が曲線)に否定の丸が付いた NOR で,どちらか一方でも1なら0になるため,A=1・B=0 で1になっているチャートと矛盾する。記号の見分け方は,入力側が平らなら AND 系,曲線なら OR 系,入力側の線が二重(曲線が2本)なら XOR 系,出力に丸が付いていれば否定付きである。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問21
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問152.次の方式で画素にメモリを割り当てる 640×480 のグラフィック LCD モジュールがある。始点(5,4)から終点(9,8)まで直線を描画するとき,直線上の x=7 の画素に割り当てられたメモリのアドレスの先頭は何番地か。ここで,画素の座標は(x,y)で表すものとする。 〔方式〕 ・メモリは0番地から昇順に使用する。 ・1画素は16ビットとする。 ・座標(0,0)から座標(639,479)までメモリを連続して割り当てる。 ・各画素は,x=0から x 軸の方向にメモリを割り当てていく。 ・x=639 の次は x=0 とし,y を1増やす。
- ア.3847
- イ.7680
- ウ.7694
- エ.8978
正解:ウ.7694
解説:図のとおりメモリは1番地が8ビットで,1画素は16ビットなので1画素につき2番地を使う。したがって座標(x,y)の画素の先頭アドレスは (y×640+x)×2 で求められる。次に x=7 のときの y を求める。直線は始点(5,4)から終点(9,8)までで,x が4増える間に y も4増えるので傾きは1であり,x=7 では y=4+(7-5)=6 になる。よって先頭アドレスは (6×640+7)×2=(3840+7)×2=3847×2=7694番地となり,答はウ。アの3847は 6×640+7 に一致し,1画素を1番地として計算して2倍を忘れた場合の値である。イの7680は 6×640×2 に一致し,行の先頭までは正しく計算したが x の分(7画素=14番地)を足し忘れた場合の値になる。エの8978は (7×640+9)×2 に一致し,x=7 を y と取り違え,かつ終点の x 座標9をそのまま使った場合の値である。座標のどちらが行を決めるのかと,1画素が何番地を占めるのかの2点を押さえるのが要点になる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問22
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問153.データセンターなどで採用されているサーバ,ネットワーク機器に対する直流給電の利点として,適切なものはどれか。
- ア.交流から直流への変換,直流から交流への変換で生じる電力損失を低減できる。
- イ.受電設備から CPU などの LSI まで,同じ電圧のまま給電できる。
- ウ.停電の危険がないので,電源バックアップ用のバッテリを不要にできる。
- エ.トランスを用いて容易に昇圧,降圧ができる。
正解:ア.交流から直流への変換,直流から交流への変換で生じる電力損失を低減できる。
解説:サーバやネットワーク機器の内部回路は直流で動くため,交流で給電すると各機器の電源装置で交流から直流へ変換する必要がある。さらに無停電電源装置(UPS)を挟む構成では,交流→直流(バッテリ充電)→交流(機器へ)→直流(機器内部)と何度も変換が入り,そのたびに損失と発熱が生じる。直流給電にすればこの往復の変換を減らせるので電力損失を低減でき,発熱が減る分だけ冷却の負荷も下がる。したがって答はア。イは誤りで,受電した電圧をそのまま LSI に加えることはできない。データセンターの直流給電は380V などで配電し,機器内部で1V 前後まで段階的に降圧するので,電圧変換自体は依然として必要である。ウも誤りで,直流給電にしても商用電源が止まれば停電するので,バッテリによるバックアップは変わらず必要である。むしろ直流ならバッテリを直流母線に直結できるという利点がある。エは交流の性質で,トランス(変圧器)は電磁誘導を使うため交流でなければ働かない。直流の電圧変換にはチョッパなどの半導体回路を用いる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問23
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問154.ビットマップフォントよりも,アウトラインフォントの利用が適している場合はどれか。
- ア.英数字だけでなく,漢字も表示する。
- イ.各文字の幅を一定にして表示する。
- ウ.画面上にできるだけ高速に表示する。
- エ.文字を任意の倍率に拡大して表示する。
正解:エ.文字を任意の倍率に拡大して表示する。
解説:ビットマップフォントは文字の形を点の並び(画素の集まり)として持つ方式で,決まった大きさで表示するぶんには美しいが,拡大すると点が大きくなって輪郭が階段状に荒れる。アウトラインフォントは文字の輪郭を直線や曲線の数式(ベジェ曲線など)で持つ方式なので,どの倍率に拡大・縮小しても輪郭を計算し直して滑らかに描ける。したがって答はエ。アは,漢字を表示できるかどうかは字形データが用意されているかの問題であり,どちらの方式でも漢字を扱える。イの各文字の幅を一定にするのは等幅(固定ピッチ)という書体の性質で,方式の違いとは別の話である。ウは逆で,ビットマップフォントは点の並びをそのまま画面に転送すればよいので描画が速く,アウトラインフォントは輪郭から実際の点を求める計算(ラスタライズ)が必要なため相対的に遅い。処理能力が限られた組込み機器で決まった大きさの文字だけを出す場合には,今もビットマップフォントが使われている。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問24
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問155.ストアドプロシージャの利点はどれか。
- ア.アプリケーションプログラムからネットワークを介して DBMS にアクセスする場合,両者間の通信量を減少させる。
- イ.アプリケーションプログラムからの一連の要求を一括して処理することによって,DBMS 内の実行計画の数を減少させる。
- ウ.アプリケーションプログラムからの一連の要求を一括して処理することによって,DBMS 内の必要バッファ数を減少させる。
- エ.データが格納されているディスク装置への I/O 回数を減少させる。
正解:ア.アプリケーションプログラムからネットワークを介して DBMS にアクセスする場合,両者間の通信量を減少させる。
解説:ストアドプロシージャは,一連の SQL 文と手続的な処理をあらかじめ DBMS 側に登録しておき,アプリケーションからは名前と引数を渡して呼び出す仕組みである。個々の SQL 文を1つずつ送って結果を受け取るのに比べ,やり取りが「呼出し1回と結果1回」に減るので,ネットワークを介する構成では通信量と往復の回数が大幅に減る。したがって答はア。ほかにも,構文解析と実行計画の作成が登録時に済んでいるので実行が速い,処理をサーバ側に集約できるので複数のアプリケーションで共通化できる,表への直接のアクセス権を与えずに済むのでセキュリティ上も有利,といった利点がある。イは,実行計画は SQL 文ごとに作られるものであり,まとめて呼び出しても中で実行される SQL 文の数は変わらないので,計画の数が減るわけではない。ウのバッファ数も,実際に読み書きするデータ量で決まるため呼出し方をまとめても減らない。エの I/O 回数も同様で,必要なデータを読む回数はストアドプロシージャにしても変わらない。減るのは「アプリケーションと DBMS の間の通信」だけである。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問25
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問156.モジュール結合度に関する記述のうち,適切なものはどれか。
- ア.あるモジュールが CALL 命令を使用せずに JUMP 命令でほかのモジュールを呼び出すとき,このモジュール間の関係は,外部結合である。
- イ.実行する機能や論理を決定するために引数を受け渡すとき,このモジュール間の関係は,内容結合である。
- ウ.大域的な単一のデータ項目を参照するモジュール間の関係は,制御結合である。
- エ.大域的なデータを参照するモジュール間の関係は,共通結合である。
正解:エ.大域的なデータを参照するモジュール間の関係は,共通結合である。
解説:モジュール結合度は,結合が弱いほど独立性が高く良い設計とされ,弱いほうから順にデータ結合,スタンプ結合,制御結合,外部結合,共通結合,内容結合の6段階に分類される。共通結合は,複数のモジュールが共通のデータ領域(大域的なデータの集まり)を参照する関係で,エがこれに当たるので答はエ。共通領域を書き換えると,どのモジュールに影響が及ぶかを追いにくくなるため独立性は低い。ウは,大域的な「単一のデータ項目」を参照する関係を制御結合としているが,これは外部結合の説明である。共通結合との違いは,共有するものがデータの集まり(レコードや構造体)か,単一の項目かという点にある。イは,実行する機能や論理を決めるための引数(制御フラグ)を渡す関係を内容結合としているが,これは制御結合の説明である。呼ばれた側の内部の動きを呼ぶ側が決めてしまうため,データだけを渡すデータ結合より結合が強い。アは,CALL を使わず JUMP で他のモジュールの内部へ飛び込む関係を外部結合としているが,これは最も結合が強い内容結合に当たる。3つの誤りはいずれも段階を1つずらした形になっている。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問46
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問157.ソフトウェア信頼度成長モデルの一つであって,テスト工程においてバグが収束したと判定する根拠の一つとして使用するゴンペルツ曲線はどれか。
- ア.
- イ.
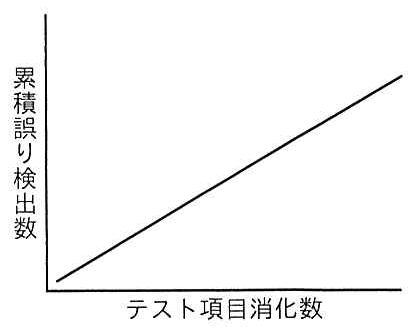
- ウ.
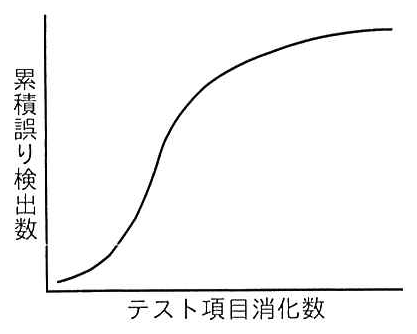
- エ.
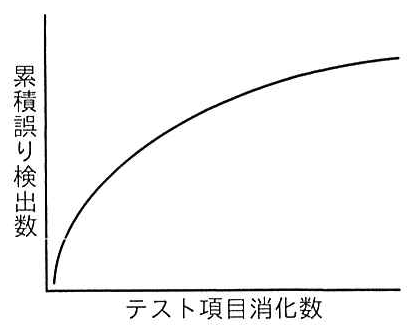
正解:ウ.
解説:ゴンペルツ曲線は,横軸にテスト項目の消化数,縦軸に累積の誤り検出数を取ったときに現れる S 字型の曲線である。テストの初期は環境の整備や単純な不具合の処理に時間が掛かって検出数の伸びがゆるやかで,中盤に入ると次々に誤りが見つかって急に立ち上がり,後半は残っている誤りが少なくなって伸びが鈍り,やがて水平に近づく。この水平に近づいた状態を「バグが収束した」と判断する根拠の一つに使う。したがって S 字型のウが答え。アは右上がりに際限なく急になっていく形で,検出数がまだ加速している途中を示しており,収束の判定には使えない。イは直線で,テスト項目を消化した分だけ一定の割合で誤りが見つかり続けることを意味するので,こちらも収束していない。エは最初から急に立ち上がって次第に寝ていく形(対数曲線に近い形)で,後半で飽和する点はゴンペルツ曲線と似ているが,初期の立ち上がりがゆるやかでないため S 字にはならない。同じ信頼度成長モデルでも,このように立ち上がりの形が異なるものはロジスティック曲線などとして区別される。判定に使うときは,実測値を当てはめて予測される総誤り数に対し,どこまで検出できたかを見るという使い方をする。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問47
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問158.リーンソフトウェア開発において,ソフトウェア開発のプロセスとプロセスの所要時間とを可視化し,ボトルネックや無駄がないかどうかを確認するのに用いるものはどれか。
- ア.ストーリーカード
- イ.スプリントバックログ
- ウ.バーンダウンチャート
- エ.バリューストリームマップ
正解:エ.バリューストリームマップ
解説:バリューストリームマップは,材料や情報が価値になって顧客に届くまでの流れ(バリューストリーム)を1枚の図に描き,各工程の所要時間と,工程間で待たされている時間を並べて可視化する道具である。もともとトヨタ生産方式に由来し,リーンソフトウェア開発では要求が出てから稼働環境へ届くまでの流れに当てはめて用いる。実際に描くと,作業している時間よりも承認や引継ぎを待っている時間のほうが長いことが見え,どこを直せば全体が速くなるか(ボトルネック)と,価値を生んでいない工程(無駄)が特定できる。したがって答はエ。アのストーリーカードは,利用者の要求をひとまとまりの短い文で書いたカードで,見積りと優先順位付けの単位になる。イのスプリントバックログは,スクラムでそのスプリントに取り組む作業の一覧である。ウのバーンダウンチャートは,残作業量が日を追ってどれだけ減ったかを折れ線で示す図で,進捗の把握には有効だが,工程ごとの所要時間や待ち時間の内訳は表さない。「工程の流れと時間の内訳を見る」のはバリューストリームマップだけである。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問48
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問159.JIS X 33002:2017(プロセスアセスメント実施に対する要求事項)の説明として,適切なものはどれか。
- ア.組織のプロセスを継続的に改善して品質を高めるための要求事項を規定している。
- イ.組織プロセスの品質を客観的に診断するための要求事項を規定している。
- ウ.プロジェクトの実施に重要で,かつ,影響を及ぼすプロジェクトマネジメントの概念及びプロセスに関する包括的な手引きを規定している。
- エ.明確に定義された用語を使用し,ソフトウェアライフサイクルプロセスの共通枠組みを規定している。
正解:イ.組織プロセスの品質を客観的に診断するための要求事項を規定している。
解説:JIS X 33002 は,プロセスアセスメント(プロセスの評定)をどのように実施すべきかを定めた規格である。アセスメントとは,組織が実際に行っているプロセスを定められた測定枠組みに照らして客観的に診断し,達成の度合いを判定することをいう。この規格は,アセスメントの計画,証拠の収集,評定,結果の報告といった実施に対する要求事項を規定しているので,答はイ。ISO/IEC 33000 シリーズ(旧 SPICE)の一部で,能力水準を判定する仕組みを共通化することによって,組織や国をまたいで比較できるようにしている。アの「継続的に改善して品質を高めるための要求事項」はプロセス改善そのものの規格の説明で,診断の実施方法を定めたこの規格の説明ではない。診断は改善の出発点になるが,両者は別の規格に分かれている。ウは JIS Q 21500(プロジェクトマネジメントの手引)の説明である。エは JIS X 0160(ISO/IEC 12207 ソフトウェアライフサイクルプロセス)の説明で,企画から開発,運用,保守,廃棄までのプロセスに共通の用語と枠組みを与えるものである。「測る側の決まり」がJIS X 33002 だと押さえると区別できる。
出典:情報処理推進機構「令和6年度春期 応用情報技術者試験 午前問題」問49
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問160.M/M/1 の待ち行列モデルにおいて,窓口の利用率が 25%から 40%に増えると,平均待ち時間は何倍になるか。
- ア.1.25
- イ.1.60
- ウ.2.00
- エ.3.00
正解:ウ.2.00
解説:M/M/1 の平均待ち時間は,利用率を ρ,平均サービス時間を Ts として Tw=ρ/(1-ρ)×Ts で表される。サービス時間は変わらないので,倍率は ρ/(1-ρ) の比だけで決まる。利用率25%では 0.25/0.75=1/3,40%では 0.40/0.60=2/3 なので,倍率は (2/3)÷(1/3)=2.00倍となり,答はウ。ρ/(1-ρ) は利用率が上がるほど急に増える形で,たとえば50%で1倍,80%で4倍,90%で9倍と,混み合ってくると待ち時間が跳ね上がる。利用率が15ポイント増えただけで待ち時間が2倍になるのは,この非線形性のためである。イの1.60は 0.40÷0.25 で,利用率そのものの比を待ち時間の比と取り違えた場合の値である。アの1.25は (1-0.25)÷(1-0.40)=0.75÷0.60 に一致し,これは待ち時間ではなく平均滞在時間(待ち時間+サービス時間)の比に当たる。エの3.00は,利用率の比(1.6倍)でも滞在時間の比(1.25倍)でもなく,この条件からは導けない値である。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問1
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問161.AI における教師あり学習での交差検証に関する記述はどれか。
- ア.過学習を防ぐために,回帰モデルに複雑さを表すペナルティ項を加え,訓練データへ過剰に適合しないようにモデルを調整する。
- イ.学習の精度を高めるために,複数の異なるアルゴリズムのモデルで学習し,学習の結果は組み合わせて評価する。
- ウ.学習モデルの汎化性能を高めるために,単一のモデルで関連する複数の課題を学習することによって,課題間に共通する要因を獲得する。
- エ.学習モデルの汎化性能を評価するために,データを複数のグループに分割し,一部を学習に残りを評価に使い,順にグループを入れ替えて学習と評価を繰り返す。
正解:エ.学習モデルの汎化性能を評価するために,データを複数のグループに分割し,一部を学習に残りを評価に使い,順にグループを入れ替えて学習と評価を繰り返す。
解説:交差検証(クロスバリデーション)は,手持ちのデータを k 個のグループに分け,そのうち1つを評価用,残りを学習用として学習と評価を行い,評価用のグループを順に入れ替えて k 回繰り返す方法である。k 回の評価結果を平均することで,どのデータを評価に使ったかという偶然の影響を減らし,未知のデータに対する性能(汎化性能)をより確かに見積もれる。したがって答はエ。データが少なく,学習用と評価用に分けると評価用が心もとない場合にとくに有効である。アは,モデルの複雑さに応じた罰則を目的関数に加えて係数が大きくなりすぎるのを抑える正則化の説明で,過学習を防ぐ手法だが評価の方法ではない。イは,複数のモデルの予測を組み合わせて精度を高めるアンサンブル学習(バギングやブースティングなど)の説明である。ウは,関連する複数の課題を1つのモデルで同時に学習させ,課題に共通する特徴を得るマルチタスク学習の説明である。いずれも機械学習の重要な手法だが,データを分割して学習と評価を入れ替えながら繰り返すのは交差検証である。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問2
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問162.式 A+B×C の逆ポーランド表記法による表現として,適切なものはどれか。
- ア.+×CBA
- イ.×+ABC
- ウ.ABC×+
- エ.CBA+×
正解:ウ.ABC×+
解説:逆ポーランド表記法(後置記法)は,演算子を対象となる二つの項の後ろに置く書き方である。A+B×C は乗算が加算より優先されるので,まず B×C を後置記法で書くと BC× となり,これを A に加えるので A(BC×)+,すなわち ABC×+ となる。したがって答はウ。この表記は括弧を使わずに計算の順序を一意に表せるため,スタックを使って左から順に読むだけで計算できる。実際 ABC×+ を処理すると,A・B・C を積み,×で上2つ(B と C)を取り出して掛け,その結果と A を+で足す,という流れになり元の式と一致する。アの+×CBA は演算子を前に置く前置記法(ポーランド表記法)の形だが,正しい前置記法は +A×BC であり,これはその並びを逆にしただけのものである。イの×+ABC も前置記法の形だが,これは (A+B)×C を表す ×+ABC であり演算の優先順位が違う。エの CBA+×は,後置記法として読むと +で C と B を足し,×でその結果と A を掛けることになり,(C+B)×A を表してしまう。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問3
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問163.自動車の先進運転支援システムで使用されるセンサーの説明のうち,適切なものはどれか。
- ア.可視光カメラは,天候などの影響を受けやすいが,交通標識の認識に使用できる。
- イ.超音波センサーは,天候などの影響を受けやすいが,測定可能距離が500メートル以上と長い。
- ウ.ミリ波レーダーは,天候などの影響を受けにくく,交通信号機の灯色の判別に使用できる。
- エ.レーザーレーダーは,天候などの影響を受けにくく,建物の後ろにある物体を検知できる。
正解:ア.可視光カメラは,天候などの影響を受けやすいが,交通標識の認識に使用できる。
解説:可視光カメラは人の目と同じ波長の光を捉えるので,色や文字,形を読み取れる。交通標識や車線の白線,信号の色の認識はカメラの得意分野である。一方で,逆光,夜間,濃霧,豪雨といった条件では見え方が大きく変わり,天候の影響を受けやすい。この長所と短所を正しく述べているのはアで,これが答え。イの超音波センサーは,音波の減衰が大きく測定できるのは数メートル程度で,駐車支援のように至近距離の障害物を検知する用途に使われる。500メートル以上という記述が誤りである。ウのミリ波レーダーは,電波を使うので雨や霧に強く,距離と相対速度を精度よく測れるが,色を見分ける仕組みをもたないので信号機の灯色は判別できない。エのレーザーレーダー(LiDAR)は,レーザー光の反射で周囲の形状を細かく測れるが,光は直進するため遮蔽物の裏側は見えない。建物の後ろの物体を検知できるという記述が誤りである。実際の運転支援では,これらを組み合わせて互いの弱点を補う設計(センサーフュージョン)が採られる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問4
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問164.次の2分探索木から要素12を削除したとき,その位置に別の要素を移動するだけで2分探索木を再構成するには,削除された要素の位置にどの要素を移動すればよいか。
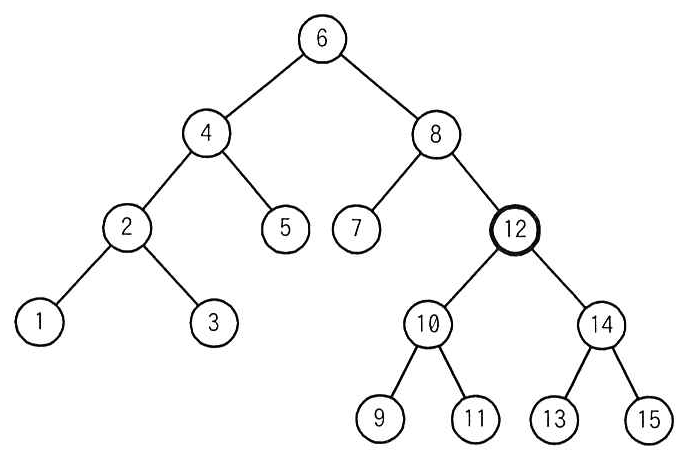
- ア.9
- イ.10
- ウ.13
- エ.14
正解:ウ.13
解説:2分探索木で節を削除したあと,1つの要素を動かすだけで木を保てるのは,その節の位置に「左部分木の最大値」または「右部分木の最小値」を持ってくる場合である。どちらもその値より小さい要素・大きい要素を新たにまたがせないので,探索木の条件が崩れない。要素12の左部分木は10を根とする{9,10,11}で最大値は11,右部分木は14を根とする{13,14,15}で最小値は13である。選択肢にあるのは13なので答はウ。13を12の位置へ移すと,左に{9,10,11},右に14(その右に15)が付き,13より小さい要素だけが左,大きい要素だけが右に並ぶので条件を満たす。13はもともと葉なので,動かしても子の付け替えが要らない点も重要である。アの9は,左部分木の最小値であって最大値ではないため,移した先の左側に10と11という9より大きい要素が残ってしまう。イの10とエの14は,どちらも子を二つ持つ節なので,動かすとその子の置き場所を決め直す必要があり「別の要素を移動するだけ」では済まない。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問5
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問165.自然数をキーとするデータを,ハッシュ表を用いて管理する。キー x のハッシュ関数 h(x)を h(x)=x mod n とすると,任意のキー a と b が衝突する条件はどれか。ここで,n はハッシュ表の大きさであり,x mod n は x を n で割った余りを表す。
- ア.a+b が n の倍数
- イ.a-b が n の倍数
- ウ.n が a+b の倍数
- エ.n が a-b の倍数
正解:イ.a-b が n の倍数
解説:衝突とは異なるキーが同じハッシュ値になることなので,条件は a mod n=b mod n である。a を n で割った商を q₁・余りを r,b を n で割った商を q₂・余りを r とすると,a=q₁n+r,b=q₂n+r なので a-b=(q₁-q₂)n となり,差が n の倍数になる。逆に a-b が n の倍数なら余りは等しい。したがって答はイ。たとえば n=10 のとき,23 と 43 は差が20で10の倍数なのでどちらも余り3となって衝突する。アの a+b が n の倍数は,n=10 で a=3,b=7 のとき和は10で条件を満たすが,余りは3と7で異なるので衝突しない。ウとエは「n が◯の倍数」と向きが逆で,n はハッシュ表の大きさという固定値なので,キーの和や差の倍数であるという条件は意味をなさない。実際 n=10・a=23・b=43 では a-b=-20 で,n が a-b の倍数にはなっていないのに衝突する。なおハッシュ表の大きさ n は素数にすると,キーの並びに規則性がある場合でも余りが偏りにくく,衝突を減らせる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問6
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問166.次の特徴をもつプログラム言語及び実行環境であって,オープンソースソフトウェアとして提供されているものはどれか。 〔特徴〕 ・統計解析や機械学習に適している。 ・データ分析,グラフ描画などの,多数のソフトウェアパッケージが提供されている。 ・変数自体には型がなく,変数に代入されるオブジェクトの型は実行時に決まる。
- ア.Go
- イ.Kotlin
- ウ.R
- エ.Scala
正解:ウ.R
解説:R は統計解析のために作られた言語と実行環境で,オープンソースソフトウェアとして提供されている。CRAN と呼ばれる公式のリポジトリに,回帰分析・多変量解析・時系列分析・機械学習・グラフ描画(ggplot2 など)といった膨大なパッケージが集まっているのが最大の特徴である。変数の宣言に型を書かず,代入されたオブジェクトの型が実行時に決まる動的型付けの言語でもある。三つの特徴すべてに当てはまるので答はウ。アの Go は Google が開発したコンパイル型の言語で,静的型付けであり,並行処理の書きやすさとビルドの速さが特徴で,サーバやツールの開発に使われる。イの Kotlin は JVM 上で動く静的型付けの言語で,Java と相互運用でき,Android アプリ開発の主要言語になっている。エの Scala も JVM 上の静的型付け言語で,オブジェクト指向と関数型を融合しており,分散処理基盤の Apache Spark で使われることから大規模データ処理と縁があるが,変数に型がないという特徴には当てはまらない。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問7
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問167.RISC プロセッサの5段パイプラインの命令実行制御の順序はどれか。ここで,このパイプラインのステージは次の五つとする。 ① 書込み ② 実行とアドレス生成 ③ 命令デコードとレジスタファイル読出し ④ 命令フェッチ ⑤ メモリアクセス
- ア.③,④,②,⑤,①
- イ.③,⑤,②,④,①
- ウ.④,③,②,⑤,①
- エ.④,⑤,③,②,①
正解:ウ.④,③,②,⑤,①
解説:パイプラインは1つの命令の処理を段階に分け,段階をずらして次の命令を流し込むことで処理効率を上げる仕組みである。RISC の代表的な5段構成は,命令フェッチ(IF)→命令デコードとレジスタ読出し(ID)→実行とアドレス生成(EX)→メモリアクセス(MEM)→レジスタへの書込み(WB)の順で,設問の番号に置き換えると ④→③→②→⑤→① となる。したがって答はウ。この順序には理由がある。命令を読み込まなければ何をするか分からないので IF が最初,何をするか分かってからでないとレジスタを読めないので ID が次,読んだ値でなければ演算やアドレス計算ができないので EX が続き,アドレスが決まってからメモリに触るので MEM,最後に結果をレジスタへ書き戻す。アは命令デコードを命令フェッチより前に置いており,まだ読み込んでいない命令を解読することになる。イはメモリアクセスを実行より前に置いたうえで命令フェッチを4番目に回しており,順序が二重に崩れている。エはメモリアクセスをデコードより前に置いており,アクセス先のアドレスが決まる前にメモリに触ることになる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問8
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問168.量子超越性(Quantum Supremacy)の説明として,適切なものはどれか。
- ア.重ね合わせという現象を用いた量子暗号が,現在の暗号化方式よりもはるかに安全であること
- イ.従来のコンピュータが古典物理学に依拠する段階にとどまっているのに比べて,量子コンピュータが量子力学に依拠して作られていること
- ウ.従来のコンピュータでは実用的な時間で処理することができない計算を,量子コンピュータでは高速に実行できること
- エ.同一の性能を実現した従来のコンピュータに比べて,量子コンピュータの物理的な大きさを圧倒的に小さくできること
正解:ウ.従来のコンピュータでは実用的な時間で処理することができない計算を,量子コンピュータでは高速に実行できること
解説:量子超越性は,従来のコンピュータ(古典コンピュータ)では現実的な時間で解ききれない計算を,量子コンピュータが実行してみせることを指す言葉である。2019年に Google が,特定の乱数生成の問題で当時のスーパーコンピュータでは1万年かかると見積もった計算を約200秒で行ったと発表し,量子超越性を達成したと主張した例が知られている。したがって答はウ。あくまで「ある特定の問題で速さが上回る」という主張であって,あらゆる計算で有利になるわけではない点が重要で,実用上の有用性を示す段階には至っていない。アは量子鍵配送などの量子暗号の話で,計算の速さではなく通信の安全性に関する概念である。イは量子コンピュータが量子力学の原理に基づいて作られているという構成上の説明で,これは量子コンピュータそのものの定義に近く,超越性という「性能で上回った」という主張とは別である。エは装置の物理的な大きさの話で,実際の量子コンピュータは極低温に冷やす大型の設備を必要とし,むしろ小型化とは縁遠い。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問9
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問169.キャッシュメモリのアクセス時間が主記憶のアクセス時間の 1/30 で,ヒット率が95%のとき,実効メモリアクセス時間は,主記憶のアクセス時間の約何倍になるか。
- ア.0.03
- イ.0.08
- ウ.0.37
- エ.0.95
正解:イ.0.08
解説:実効メモリアクセス時間は「ヒット率×キャッシュのアクセス時間+(1-ヒット率)×主記憶のアクセス時間」で求める。主記憶のアクセス時間を1とすると,キャッシュは 1/30 なので 0.95×(1/30)+0.05×1=0.0317+0.05=0.0817 となり,約0.08倍である。答はイ。この式で分かるのは,キャッシュをいくら速くしても,ミスした残り5%分(0.05)が下限として残るという点である。実際キャッシュのアクセス時間を0と極端に仮定しても0.05倍より小さくはならず,ヒット率を上げることのほうが効きやすい。アの0.03は 0.95×(1/30)=0.0317 に一致し,ミスした場合の項を足し忘れた値である。ウの0.37は 0.95×(1/3)+0.05=0.3667 に一致し,キャッシュのアクセス時間を 1/30 ではなく 1/3 と取り違えた場合の値になる。エの0.95は 0.05×(1/30)+0.95×1=0.9517 に一致し,ヒット率とミス率を逆に当てはめた場合の値である。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問10
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問170.ストレージのインタフェースとして用いられる FC(ファイバチャネル)の特徴として,適切なものはどれか。
- ア.TCP/IP の上位層として作られた規格である。
- イ.接続形態は,スイッチを用いた n 対 n 接続に限られる。
- ウ.伝送媒体には電気ケーブル又は光ケーブルを用いることができる。
- エ.物理層としてパラレル SCSI を用いることができる。
正解:ウ.伝送媒体には電気ケーブル又は光ケーブルを用いることができる。
解説:FC(ファイバチャネル)は,サーバとストレージを高速に結ぶための規格で,名前に「ファイバ」と付くが伝送媒体は光ファイバに限られず,短い距離では同軸などの電気ケーブルも使える。したがって答はウ。SAN(ストレージエリアネットワーク)を構成する代表的な技術で,SCSI のコマンドを FC のフレームに載せて運ぶ(FCP)ため,OS からは直接つながったディスクのように見える。アは,FC は独自の階層をもつ規格で TCP/IP の上位層ではない。TCP/IP 上で SCSI を運ぶのは iSCSI,イーサネット上で FC を運ぶのは FCoE である。イは,接続形態には機器を1対1でつなぐポイントツーポイント,リング状につなぐアービトレイテッドループ,スイッチを介してつなぐファブリックの3種類があり,スイッチを使う形に限られない。エは,FC はパラレル SCSI を置き換えるために作られたシリアル伝送の規格で,パラレル SCSI を物理層に使うことはできない。ケーブルが細く長距離を引けることが,パラレル方式に対する利点である。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問11
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問171.Web アプリケーションサーバの信頼性に関する記述のうち,適切なものはどれか。
- ア.コールドスタンバイ構成で稼働しているサーバに障害が発生した場合,サービスは中断しないが,トランザクションは継続できない。
- イ.コールドスタンバイ構成で稼働しているサーバに障害が発生した場合,サービスは中断するが,トランザクションは継続できる。
- ウ.セッションを共有しないクラスタ構成で1台のサーバに障害が発生した場合,サービスは継続できないが,トランザクションは継続できる。
- エ.セッションを共有するクラスタ構成で1台のサーバに障害が発生した場合,サービス及びトランザクションは継続できる。
正解:エ.セッションを共有するクラスタ構成で1台のサーバに障害が発生した場合,サービス及びトランザクションは継続できる。
解説:複数台のサーバでクラスタを組み,セッション情報を共有(レプリケーション)しておくと,1台が落ちても他のサーバが同じセッションの状態を持っているので,利用者は入力の途中でもそのまま処理を続けられる。サービスもトランザクションも継続できるので,答はエ。アとイのコールドスタンバイは,待機系のサーバを停止した状態で用意しておき,障害が起きてから起動して引き継ぐ方式である。起動と切替えに時間がかかるためサービスは必ず中断し,稼働系が持っていた処理途中のデータも引き継げないのでトランザクションも継続できない。したがってアの「サービスは中断しない」もイの「トランザクションは継続できる」も誤りである。ウは,セッションを共有しないクラスタでも,残ったサーバが新しい要求を引き受けるのでサービス自体は継続できる。継続できないのは,障害が起きたサーバが保持していたセッションとその上のトランザクションのほうであり,記述が入れ替わっている。段階を整理すると,コールドスタンバイ→ホットスタンバイ→クラスタ(セッション共有なし)→クラスタ(セッション共有あり)の順に,止まらない度合いが上がっていく。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問12
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問172.データアクセス方式の一つであるオブジェクトストレージに関する記述のうち,最も適切なものはどれか。
- ア.ストレージにファイルシステムを構成し,ファイル単位でデータにアクセスする。
- イ.ストレージの論理ボリュームを決まったサイズに分割し,その単位でデータにアクセスする。
- ウ.データとメタデータをセットにして保存し,階層構造にすることによってデータにアクセスする。
- エ.データとメタデータをセットにして保存し,固有の識別子でデータにアクセスする。
正解:エ.データとメタデータをセットにして保存し,固有の識別子でデータにアクセスする。
解説:オブジェクトストレージは,データ本体とそれを説明するメタデータを一つの「オブジェクト」としてまとめ,一意の識別子(キー)を指定して読み書きする方式である。ディレクトリをたどる必要がないため,格納場所の物理的な構成に縛られず,台数を増やすだけで容量と性能を伸ばせる。したがって答はエ。クラウドの大容量ストレージや,画像・ログ・バックアップの保管に広く使われている。アはファイルストレージの説明で,ストレージ上にファイルシステムを作り,ディレクトリとファイル名でアクセスする方式である。イはブロックストレージの説明で,論理ボリュームを固定長のブロックに分け,ブロック番号を指定して読み書きする。データベースのように細かい更新を高速に行う用途に向く。ウはメタデータをセットで保存する点まではオブジェクトストレージと同じだが,「階層構造にすることによってアクセスする」が誤りである。オブジェクトストレージの名前空間は階層をもたないフラットな構造で,これが台数を増やしやすい理由になっている。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問13
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問173.稼働率が等しい装置 X を直列や並列に組み合わせたとき,システム全体の稼働率を高い順に並べたものはどれか。ここで,装置 X の稼働率は0よりも大きく1未満である。
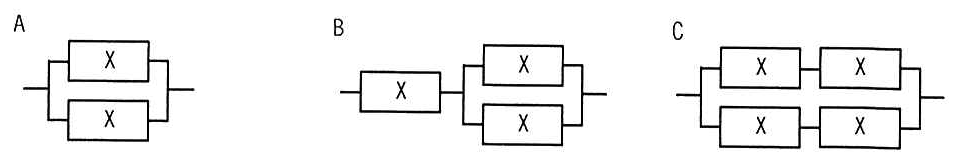
- ア.A,B,C
- イ.A,C,B
- ウ.C,A,B
- エ.C,B,A
正解:イ.A,C,B
解説:装置1台の稼働率を a として,3つの構成の稼働率を式にする。A は2台の並列だけなので 1-(1-a)²=2a-a²。B は1台の直列に2台の並列が続くので a×(2a-a²)=2a²-a³。C は「2台直列」を2組並列にした形なので 1-(1-a²)²=2a²-a⁴ となる。a=0.5 で確かめると A=0.75,C=0.4375,B=0.375 で A>C>B となり,答はイ。この大小関係は 0<a<1 の全域で成り立つ。C-B=a³-a⁴=a³(1-a) で正,A-C=2a-3a²+a⁴=a(a-1)²(a+2) でこれも正だからである。直感的にも,A は直列部分がまったく無いので最も高く,B は「1台でも壊れたら全体が止まる装置」が単独で1台あるため最も低い。C は直列2台の組を丸ごと2系統に冗長化しているので,その中間になる。アは B と C の順が逆,ウとエは A を C より低く置いており,直列部分をもたない A が最も高いという点を捉えていない。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問14
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問174.あるクライアントサーバシステムにおいて,クライアントから要求された1件の検索を処理するために,サーバで平均100万命令が実行される。1件の検索につき,ネットワーク内で転送されるデータは平均 2×10⁵ バイトである。このサーバの性能は 100 MIPS であり,ネットワークの転送速度は 8×10⁷ ビット/秒である。このシステムにおいて,1秒間に処理できる検索要求は何件か。ここで,処理できる件数は,サーバとネットワークの処理能力だけで決まるものとする。また,1バイトは8ビットとする。
- ア.50
- イ.100
- ウ.200
- エ.400
正解:ア.50
解説:サーバ側とネットワーク側のそれぞれで1秒間に処理できる件数を求め,小さいほう(能力の低い側=ボトルネック)が答えになる。サーバは 100 MIPS=1秒間に1億(10⁸)命令を実行でき,1件に100万(10⁶)命令が必要なので 10⁸÷10⁶=100件/秒。ネットワークは 8×10⁷ ビット/秒で,1件のデータは 2×10⁵ バイト=2×10⁵×8=1.6×10⁶ ビットなので,8×10⁷÷(1.6×10⁶)=50件/秒である。両者のうち小さいほうは50件なので答はア。サーバの能力は100件分あるのに,ネットワークが50件分しか運べないため半分が遊ぶ形になり,増強すべきはネットワーク側だと分かる。イの100はサーバ側の能力だけを見た値で,ネットワークの制約を無視している。エの400は 8×10⁷÷(2×10⁵)=400 に一致し,バイトをビットに直さずに割った場合の値である。ウの200は,サーバ側の100件でもネットワーク側の50件でもなく,この条件からは導けない値である。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問15
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問175.タスクスケジューリング方式の説明のうち,特定のタスクが CPU 資源の割当てを待ち続ける可能性が最も高いものはどれか。
- ア.各タスクの優先度を決めて,優先度が高い順に実行し,CPU 割当てまでの待ち時間の長さに応じて優先度を徐々に上げていく。
- イ.各タスクを実行可能待ち行列に置かれた順に実行し,一定時間が経過したら実行を中断して実行可能待ち行列の最後尾に加える。
- ウ.処理予定時間が最も短いタスクから順に処理を実行する。現在実行中の処理が終了するか,又は何らかの要因によって中断されたとき,次のタスクを開始する。
- エ.タスクがシステムに到着した順に実行可能待ち行列の最後尾に加え,常に実行可能待ち行列の先頭のタスクに CPU を割り当てる。
正解:ウ.処理予定時間が最も短いタスクから順に処理を実行する。現在実行中の処理が終了するか,又は何らかの要因によって中断されたとき,次のタスクを開始する。
解説:あるタスクがいつまでも CPU をもらえない状態を飢餓(スタベーション)という。ウは処理予定時間の短いタスクを優先する方式(SJF・最短ジョブ優先)で,短いタスクが次々に到着し続けると,処理時間の長いタスクは常に後ろへ回されて実行の順番が来ない。待ち時間が伸びても順位が上がる仕組みが無いので,飢餓が起きる可能性が最も高い。したがって答はウ。アは優先度方式だが,待ち時間に応じて優先度を上げていくエイジングを組み込んでいるので,待たされているタスクはいずれ最上位に到達して実行される。まさに飢餓を防ぐための工夫である。イはラウンドロビンで,一定時間ごとに実行を打ち切って行列の最後尾へ回すため,待ち行列にいるタスクには必ず順番が回ってくる。エは到着順に処理する FCFS(先着順)で,追い越しが起きないので,先に着いたタスクは必ず実行される。ただし長いタスクが先頭にいると後続が待たされる(コンボイ効果)という別の弱点はある。飢餓が起きるのは「順位が固定で,かつ追い越しが起きる」方式だという点が見分け方になる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問16
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問176.ページング方式の仮想記憶において,ページ置換えの発生頻度が高くなり,システムの処理能力が急激に低下することがある。このような現象を何と呼ぶか。
- ア.スラッシング
- イ.スワップアウト
- ウ.フラグメンテーション
- エ.ページフォールト
正解:ア.スラッシング
解説:実行中のプログラムが必要とするページの総量が実記憶の容量を超えると,あるページを追い出した直後にそのページが再び必要になるという状態に陥る。CPU がページの入替え(ページイン・ページアウト)ばかりに時間を費やし,本来の処理がほとんど進まなくなる現象をスラッシングといい,答はア。対策は,同時に動かすプログラムの数(多重度)を下げる,実記憶を増やす,参照の局所性が高くなるようプログラムを見直すなどである。イのスワップアウトは,主記憶上のプログラムやページを補助記憶へ書き出す個々の動作を指す用語で,これ自体は正常な動作である。エのページフォールトは,参照したページが主記憶に無いという例外の発生を指し,これも仮想記憶では日常的に起きる。ウのフラグメンテーションは,記憶領域が細かく分断されて連続した空き領域が確保しにくくなる現象で,ページング方式では固定長のページを使うため外部断片化は起きない。スラッシングは,ページフォールトが頻発した結果として現れる「性能が崩壊した状態」を指す言葉であり,個々の動作や例外と区別して押さえたい。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問17
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問177.仮想記憶方式において,セグメンテーション方式と比較した場合のページング方式の長所はどれか。
- ア.記憶領域へのアクセス保護を論理的な単位で行うことができる。
- イ.記憶領域をプログラム間で容易に共用することができる。
- ウ.実行時に記憶領域の大きさを動的に変えることができる。
- エ.主記憶の外部断片化が発生しない。
正解:エ.主記憶の外部断片化が発生しない。
解説:ページング方式は,主記憶と仮想記憶を同じ大きさの固定長のページに区切って管理する。区画の大きさがそろっているので,空いているページ枠はどれでもそのまま使えて,「空きの合計は足りているのに連続した領域が取れない」という外部断片化が起きない。したがって答はエ。一方で,プログラムの論理的な区切りとページの境界は一致しないため,ページの末尾に使われない部分が残る内部断片化は生じる。アからウはいずれもセグメンテーション方式の長所である。セグメンテーションは,プログラムやデータを手続き・配列といった論理的なまとまり(セグメント)単位で可変長に区切るので,アのようにセグメントごとに読取り専用や実行可能といったアクセス保護を意味のある単位で設定でき,イのように共通のライブラリをセグメント単位でプログラム間で共用でき,ウのようにセグメントの大きさを実行時に伸縮させられる。逆に可変長であるために,割当てと解放を繰り返すと主記憶に細かい空きが散らばって外部断片化が起きる。両方式の長所を組み合わせたセグメントページング方式もある。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問18
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問178.分散開発環境において,各開発者のローカル環境に全履歴を含んだ中央リポジトリの完全な複製をもつことによって,中央リポジトリにアクセスできないときでも履歴の調査や変更の記録を可能にする,バージョン管理ツールはどれか。
- ア.Apache Subversion
- イ.CVS
- ウ.Git
- エ.RCS
正解:ウ.Git
解説:Git は分散型のバージョン管理ツールで,リポジトリを複製(クローン)すると全履歴が手元に入る。そのため,ネットワークにつながっていなくても過去の変更の調査,差分の確認,コミット(変更の記録),ブランチの作成といった操作をローカルだけで完結でき,つながったときに中央リポジトリと同期(プッシュ・プル)すればよい。したがって答はウ。アの Apache Subversion(SVN)は集中型で,履歴はサーバ側にあり,コミットするにはサーバへの接続が必要である。作業コピーには最新の状態しか持たない。イの CVS も集中型で,SVN の前の世代に広く使われたツールである。ファイル単位でリビジョンを管理するため,複数ファイルにまたがる変更をひとまとめに扱えないという弱点があり,SVN はそれを改良したものである。エの RCS はさらに古く,1つのファイルの改訂履歴を同じディレクトリ内で管理する仕組みで,複数人での共同作業を前提としていない。分散型のもう一つの代表として Mercurial があるが,選択肢には無い。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問19
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問179.手続型言語のコンパイラがコード生成までに行う処理のうち,最後に行うものはどれか。
- ア.意味解析
- イ.構文解析
- ウ.最適化
- エ.字句解析
正解:ウ.最適化
解説:コンパイラは,字句解析→構文解析→意味解析→最適化→コード生成の順に処理を進める。字句解析はソースの文字列を字句(トークン)の並びに分ける段階,構文解析はトークンの並びが文法に合っているかを調べて構文木を作る段階,意味解析は型の整合や変数の宣言漏れといった意味の面の検査を行う段階である。最適化は,作られた中間表現に対して,不要な計算の削除,ループ内の不変式の外出し,共通部分式の共有などを施して実行効率を上げる段階で,コード生成の直前に位置する。したがって「コード生成までに行う処理のうち最後」は最適化であり,答はウ。順序に理由があり,トークンに分けなければ文法は調べられず,構文木ができなければ型の検査はできず,意味まで確定しなければ意味を変えずに書き換える最適化は行えない。なお最適化は目的コードを生成した後にも行われることがあり(ピープホール最適化など),実装によっては複数の段階に分かれる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問20
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問180.図はスイッチ A 及び B の状態によって,LED が点灯又は消灯する回路である。スイッチ A がオンの状態を A=1,オフの状態を A=0 とし,スイッチ B も同様にオンの状態を B=1,オフの状態を B=0 とする。また,LED が点灯する状態を Y=1,消灯する状態を Y=0 とする。このとき,図の回路を動作させたときのタイミングチャートとして,適切なものはどれか。
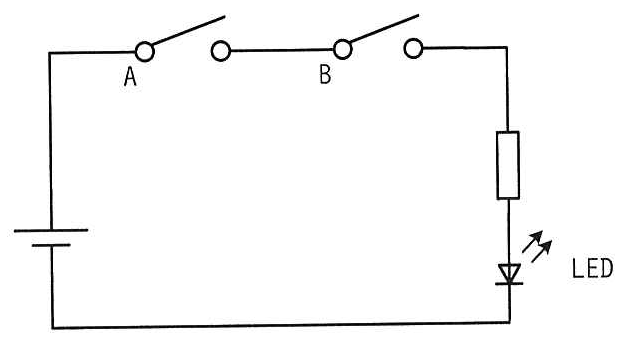
- ア.
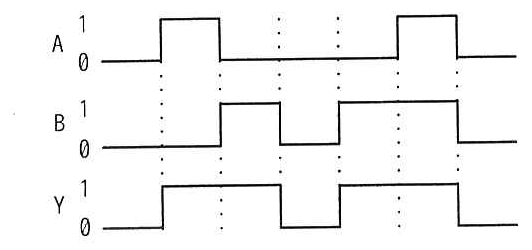
- イ.
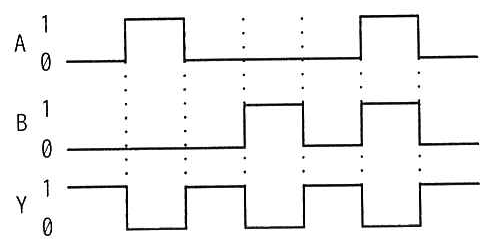
- ウ.
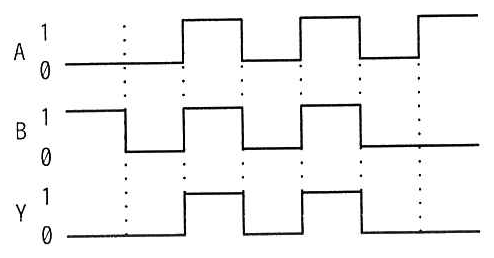
- エ.
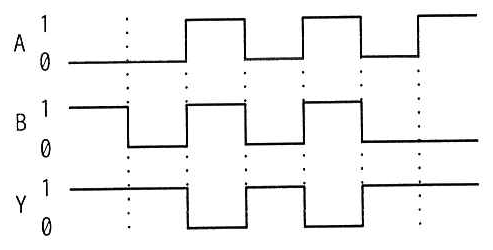
正解:ウ.
解説:図の回路は,電池からスイッチ A,スイッチ B,抵抗,LED が一本の輪になってつながっている。スイッチが直列なので,どちらか一方でもオフなら電流の道が切れて LED は消え,両方がオンのときだけ点灯する。つまり Y=A・B(論理積)の関係であり,A=1 かつ B=1 の区間だけ Y=1 になっているチャートを選べばよい。ウは,A と B がともに1になっている二つの区間だけ Y が1に立ち上がり,A だけが1の区間や B だけが1の区間では Y が0のままで,論理積と完全に一致する。したがって答はウ。エは A と B の波形がウと同じだが Y が反転しており,両方が1のときだけ0になるので論理積の否定(NAND)に当たる。アは,A だけが1の区間でも B だけが1の区間でも Y が1になっており,どちらか一方でも1なら1になる論理和(OR)の形である。イはそのアの Y を反転した形で,両方が0のときだけ1になる論理和の否定(NOR)に当たる。直列は論理積,並列は論理和に対応するという対応関係を押さえておけば,回路図から迷わず選べる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問21
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問181.SoC の説明として,適切なものはどれか。
- ア.システム LSI に内蔵されたソフトウェア
- イ.複数の MCU を搭載したボード
- ウ.複数のチップで構成していたコンピュータシステムを,一つのチップで実現した LSI
- エ.複数のチップを単一のパッケージに封入してシステム化したデバイス
正解:ウ.複数のチップで構成していたコンピュータシステムを,一つのチップで実現した LSI
解説:SoC(System on a Chip)は,従来は CPU・メモリ・周辺回路・通信機能などを別々のチップに分けて基板上で組み合わせていたコンピュータシステムを,1枚のシリコンチップの上にまとめて作り込んだ LSI である。したがって答はウ。1つのチップに収めることで,配線が短くなって高速に動作し,消費電力も基板の面積も小さくできるので,スマートフォンや家電,車載機器といった組込みシステムで広く使われている。エは,複数のチップ(ダイ)を1つのパッケージに封じ込めた SiP(System in Package)の説明で,チップ自体は複数のままという点が SoC と異なる。すでにあるチップを組み合わせられるので開発期間が短くて済む反面,1チップ化ほどの小型化・低消費電力化は望めない。アは,チップに内蔵されたソフトウェア(ファームウェアや組込みソフトウェア)の説明で,SoC はハードウェアを指す言葉である。イは,MCU(マイクロコントローラユニット)を複数載せた基板の説明で,これは「複数チップを基板上で組み合わせる」という SoC 以前のやり方に当たる。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問22
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問182.アクチュエーターの説明として,適切なものはどれか。
- ア.与えられた目標値と,センサーから得られた制御量を比較し,制御量を目標値に一致させるように操作量を出力する。
- イ.位置,角度,速度,加速度,力,温度などを検出し,電気的な情報に変換する。
- ウ.エネルギー源からのパワーを,回転,直進などの動きに変換する。
- エ.マイクロフォン,センサーなどが出力する微小な電気信号を増幅する。
正解:ウ.エネルギー源からのパワーを,回転,直進などの動きに変換する。
解説:アクチュエーターは,電気・油圧・空気圧などのエネルギーを,回転や直進といった機械的な動きに変換して外の世界に働きかける装置である。モータ,シリンダ,ソレノイド,圧電素子などがこれに当たる。したがって答はウ。制御システムを構成する要素は役割で分けられ,イは外界の物理量を電気信号に変える入力側の装置=センサーの説明である。アは,目標値と現在の制御量を比べて操作量を決める頭脳の部分=コントローラ(制御装置)の説明で,比例・積分・微分を組み合わせた PID 制御などがここで働く。エは微小な電気信号を扱える大きさまで増幅する増幅器(アンプ)の説明で,センサーの出力をコントローラが読める信号にするために使われる。全体としては,センサーが測る→アンプが整える→コントローラが判断する→アクチュエーターが動かす→その結果をまたセンサーが測る,という閉じた輪(フィードバックループ)になっており,アクチュエーターはその輪の「出口」に位置する。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問23
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問183.マイクロプロセッサの耐タンパ性を向上させる手法として,適切なものはどれか。
- ア.ESD(Electrostatic Discharge)に対する耐性を強化する。
- イ.チップ検査終了後に検査用パッドを残しておく。
- ウ.チップ内部を物理的に解析しようとすると,内部回路が破壊されるようにする。
- エ.内部メモリを物理アドレスに合わせて整然と配置する。
正解:ウ.チップ内部を物理的に解析しようとすると,内部回路が破壊されるようにする。
解説:耐タンパ性(tamper resistance)とは,機器を分解したり内部を解析したりして秘密情報を取り出そうとする攻撃に対する強さのことである。チップを削る,樹脂を溶かす,配線に探針を当てるといった物理的な解析を試みたときに,内部回路が壊れて情報が読み出せなくなる仕組みを組み込むのは代表的な手法で,答はウ。ほかにも,配線層を目くらましのパターンで覆う,電源電圧や温度の異常を検知して動作を止める,暗号鍵を不揮発メモリに平文で置かない,といった対策がある。イは逆効果で,製造時の検査に使ったパッド(端子)を残しておくと,攻撃者がそこから内部の信号を観測したりデバッグ機能を呼び出したりできてしまうため,検査後は切り離すのが原則である。エも逆効果で,メモリの配置に規則性があると,チップの写真から目的の領域を特定しやすくなる。アの ESD(静電気放電)への耐性強化は,静電気による素子の破壊を防ぐ信頼性・品質の対策であり,悪意ある解析への強さとは別の話である。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問24
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問184.Web ページの構成要素のうち,図のような固定の表示領域内でマウス操作やタッチ操作を行うことによってスクロールし,複数の画像などが横方向に順次表示されるものを何というか。
- ア.アコーディオン
- イ.カルーセル
- ウ.タブ
- エ.モーダルウィンドウ
正解:イ.カルーセル
解説:カルーセルは,決まった大きさの表示領域の中で複数の画像やパネルを横方向に順送りして見せる部品である。名前は遊園地の回転木馬(carousel)に由来し,左右の矢印やスワイプ操作で送り,下部の丸い印(インジケーター)で今が何枚目かを示すのが定型で,図の見た目と一致する。したがって答はイ。限られた面積で複数の内容を紹介できる反面,最初の1枚以外は見られないことが多いという指摘もあり,重要な情報を2枚目以降に置かない配慮が求められる。アのアコーディオンは,見出しをクリックすると下に内容が開き,別の見出しを開くと前が閉じる縦方向の折り畳み部品で,FAQ などに使われる。ウのタブは,同じ位置に重ねた複数の面を見出しの切替えで表示する部品で,切替えは利用者が明示的に選ぶ形になる。エのモーダルウィンドウは,元の画面の手前に重ねて表示し,閉じるまで背後の操作を受け付けない小窓で,確認や入力を割り込ませたいときに使う。いずれも限られた面積を活かす部品だが,横方向に順次送るのはカルーセルである。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問25
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問185.エクスプロイトコードの説明はどれか。
- ア.攻撃コードとも呼ばれ,ソフトウェアの脆弱性を悪用するコードのことであり,使い方によっては脆弱性の検証に役立つこともある。
- イ.マルウェア定義ファイルとも呼ばれ,マルウェアを特定するための特徴的なコードのことであり,マルウェア対策ソフトによるマルウェアの検知に用いられる。
- ウ.メッセージとシークレットデータから計算されるハッシュコードのことであり,メッセージの改ざん検知に用いられる。
- エ.ログインのたびに変化する認証コードのことであり,不正に取得しても再利用できないので不正アクセスを防ぐ。
正解:ア.攻撃コードとも呼ばれ,ソフトウェアの脆弱性を悪用するコードのことであり,使い方によっては脆弱性の検証に役立つこともある。
解説:エクスプロイトコードは,ソフトウェアの脆弱性を突いて意図しない動作を引き起こすプログラムやデータのことで,攻撃コードとも呼ばれる。攻撃に使われる一方で,脆弱性が本当に悪用可能かを確かめる検証(PoC=Proof of Concept)や,修正が正しく効いているかの確認にも使われるため,両面をもつ。したがって答はア。公開のしかたは慎重に扱われ,修正が行き渡る前に詳細を公開すると被害が広がる。イはマルウェアを見分けるための特徴的なパターンを集めたシグネチャ(マルウェア定義ファイル)の説明で,パターンマッチングによる検知に使われる。ウは MAC(Message Authentication Code=メッセージ認証符号)の説明で,メッセージと共有の秘密情報からハッシュ値を計算し,改ざんの検出と送信者の確認を行うものである。エはワンタイムパスワードの説明で,一度使うと無効になるため盗まれても再利用できない。いずれもセキュリティに関わる符号だが,「脆弱性を悪用する側のコード」を指すのはエクスプロイトコードである。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問46
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問186.マイクロサービスアーキテクチャを利用するとき,システム構築上の利点はどれか。
- ア.各サービスが使用する,プログラム言語,ライブラリ及びミドルウェアを統一しやすい。
- イ.各サービスが保有するデータの整合性を確保しやすい。
- ウ.各サービスの変更がしやすい。
- エ.各サービスを呼び出す回数が減るので,オーバーヘッドが削減できる。
正解:ウ.各サービスの変更がしやすい。
解説:マイクロサービスアーキテクチャは,システムを業務上の意味で小さく分けた独立したサービスの集まりとして構成し,サービス間は API で連携させる方式である。各サービスが独立して開発・配置・拡張できるので,1つを直すときに影響が他へ波及しにくく,そのサービスだけを作り直して入れ替えられる。したがって答はウ。アは逆で,サービスごとに最適な言語やミドルウェアを選べるのが利点である反面,全体としては技術が多様になって統一しにくくなる。イも逆で,データベースをサービスごとに分けるため,複数のサービスにまたがる更新は分散トランザクションのような難しい問題になり,結果整合性で運用するのが一般的である。整合性の確保は一体構成(モノリシック)のほうが容易である。エも逆で,1つの処理を複数のサービスの呼出しで組み立てるため,ネットワーク越しの通信が増えてオーバーヘッドは大きくなる。マイクロサービスは「変更のしやすさ」と「部分的な拡張のしやすさ」を得る代わりに,運用の複雑さと通信のコストを引き受ける選択だと理解しておくとよい。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問47
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問187.ソフトウェアの使用性を評価する指標の目標設定の例として,適切なものはどれか。
- ア.ソフトウェアに障害が発生してから1時間以内に,利用者が使用できること
- イ.ソフトウェアの使用方法を,利用者が1時間以内に習得できること
- ウ.利用者から要望のある機能の改善を,1週間以内に完了できること
- エ.利用者の使用したい機能が,100%提供できていること
正解:イ.ソフトウェアの使用方法を,利用者が1時間以内に習得できること
解説:使用性(ユーザビリティ)は,利用者が目的を達成するためにそのソフトウェアをどれだけ楽に使えるかを表す品質特性で,習得しやすさ,操作しやすさ,分かりやすさ,誤操作からの守りやすさなどが含まれる。「使用方法を1時間以内に習得できること」は習得しやすさを時間で測る指標なので使用性の目標設定に当たり,答はイ。アは障害が起きてから復旧して使えるようになるまでの時間を定めており,これは信頼性(回復性)や可用性の指標である。ウは要望を受けてから改善を完了するまでの時間で,これは保守性の指標に当たる。エは必要な機能がすべてそろっているかという機能適合性(機能完全性)の指標である。JIS X 25010(ISO/IEC 25010)ではソフトウェアの品質を,機能適合性・性能効率性・互換性・使用性・信頼性・セキュリティ・保守性・移植性の8つに分けており,どの特性を測っているのかを言葉から見分ける練習になる。使用性は「使う人が学び,操作する」ことに関わるという点を軸にすると迷いにくい。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問48
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問188.アジャイル開発の初期段階において,プロジェクトの目的,スコープなどに対する共通認識を得るために,あらかじめ設定されている設問と課題について関係者が集まって確認し合い,その成果を共有する手法はどれか。
- ア.アジャイルモデリング
- イ.インセプションデッキ
- ウ.プランニングポーカー
- エ.ユーザーストーリーマッピング
正解:イ.インセプションデッキ
解説:インセプションデッキは,プロジェクトを始めるときに関係者が集まり,あらかじめ決められた10個の問い(我々はなぜここにいるのか,エレベーターピッチ,パッケージデザイン,やらないことリスト,「ご近所さん」を探せ,解決策を描く,夜も眠れなくなるような問題は何か,期間を見極める,何を諦めるのか,何がどれだけ必要か)に答えを出し,その結果を1枚ずつのスライドにまとめて共有する手法である。目的やスコープ,前提とリスクについての共通認識を早い段階で作ることが狙いなので,答はイ。アのアジャイルモデリングは,必要な分だけ軽くモデルを描いて意思疎通に使うという考え方や実践の総称である。ウのプランニングポーカーは,開発者がカードを使って作業規模(ストーリーポイント)を同時に提示し,見積りの認識を合わせていく手法で,対象は個々の作業の大きさである。エのユーザーストーリーマッピングは,利用者の行動の流れに沿ってユーザーストーリーを二次元に並べ,リリースの範囲や優先順位を検討する手法である。いずれも初期に使われるが,「決まった設問に答えて全体像の合意を作る」のはインセプションデッキである。
出典:情報処理推進機構「令和6年度秋期 応用情報技術者試験 午前問題」問49
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問189.論理式 P,Q がいずれも真であるとき,論理式 R の真偽にかかわらず真になる式はどれか。ここで,“‾”は否定を,“∨”は論理和を,“∧”は論理積を,“→”は含意(“真 → 偽”となるときに限り偽となる演算)を表す。
- ア.
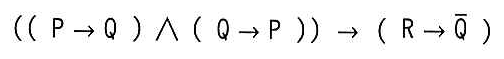
- イ.
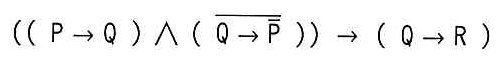
- ウ.
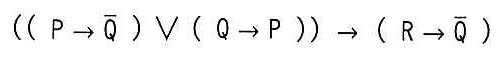
- エ.
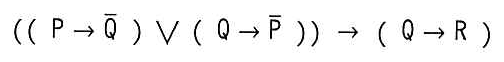
正解:エ.
解説:含意 X→Y は「X が真で Y が偽のときだけ偽」で,X が偽ならば Y の真偽にかかわらず真になる。P=真,Q=真を各式に入れて前件(→の左)を調べる。アは (P→Q)=真,(Q→P)=真で前件が真,後件は R→Q̄ すなわち R→偽なので R が真のとき偽になり,R によって値が変わる。イは (P→Q)=真,(Q→P̄)=真→偽=偽でその否定が真だから前件は真,後件は Q→R=真→R=R なので R が偽なら偽になる。ウは (P→Q̄)=真→偽=偽だが (Q→P)=真なので論理和の前件は真,後件は R→偽でアと同じく R に左右される。エは (P→Q̄)=偽,(Q→P̄)=偽で論理和が偽となり,前件が偽である以上,後件が何であっても含意は真になる。したがって R の真偽にかかわらず真になるのはエ。ポイントは「前件を偽にできれば含意は無条件に真」という点で,P と Q が真という前提のもとで否定を含む式を並べたアとエのうち,論理積ではなく論理和で前件を作っているエだけが前件を偽にできる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問1
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問190.0≦x≦1 の範囲で単調に増加する連続関数 f(x) が f(0)<0 ≦ f(1) を満たすときに,区間内で f(x)=0 である x の値を近似的に求めるアルゴリズムにおいて,(2)は何回実行されるか。 〔アルゴリズム〕 (1) x₀←0,x₁←1とする。 (2) x←(x₀+x₁)/2 とする。 (3) x₁-x<0.001 ならば x の値を近似値として終了する。 (4) f(x)≧0 ならば x₁←x として,そうでなければ x₀←x とする。 (5) (2)に戻る。
- ア.10
- イ.20
- ウ.100
- エ.1,000
正解:ア.10
解説:区間 [x₀,x₁] の幅を w とすると,(2)で x は中点になるので x₁-x=w/2 であり,(3)の判定は w/2<0.001 と同じになる。(4)ではどちらに分岐しても新しい区間の幅は w/2 になるので,幅は1回ごとに半分になる。最初の幅は 1-0=1 だから,(2)の k 回目の実行時点の幅は 1/2^(k−1) で,判定式は 1/2^k<0.001,すなわち 2^k>1,000 となる。2⁹=512 では足りず 2¹⁰=1,024 で初めて超えるので k=10 が最初に条件を満たし,(2)は10回実行されて終了する。答はア。この手続きは2分探索法(区間を半分に狭める方法)で,精度を10倍細かくしても回数は約3.3回しか増えない。イの20は必要な精度を 0.001 ではなく 0.000001 と取り違えた場合の回数で,2²⁰=1,048,576>10⁶ より20回になる。エの1,000は区間を毎回0.001ずつ等間隔に狭めると誤解した場合の 1÷0.001 で,ウの100は同じ誤解で刻みを0.01と取った場合の 1÷0.01 である。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問2
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問191.AI における機械学習の過程において,過学習と疑われたときの解消方法として,最も適切なものはどれか。
- ア.訓練した時と同じ精度を出すために,訓練データをテストデータとして使用する。
- イ.精度を高めるために,元の訓練データに加工を施し,訓練データの量を増やす。
- ウ.予測した結果に近づけるために,モデルをより複雑にする。
- エ.より多くの未知のデータに対して予測できるように,汎化性能を下げる。
正解:イ.精度を高めるために,元の訓練データに加工を施し,訓練データの量を増やす。
解説:過学習(オーバーフィッティング)は,モデルが訓練データの細部や雑音まで覚え込んでしまい,訓練データに対する精度は高いのに未知のデータに対する精度が落ちる状態をいう。対策の柱は「データを増やす」「モデルを単純にする」「正則化や早期打切りを入れる」の3つで,イの,元の訓練データを回転・反転・ノイズ付加などで加工して量を増やす手法はデータ拡張(データオーグメンテーション)と呼ばれ,データを新たに集められない場合の代表的な対策である。したがって答はイ。アは訓練データをそのままテストに使うので高い精度が出るのは当然で,未知データへの性能を測れなくなる。過学習を隠してしまう最悪の手であり,解消にはならない。ウはモデルを複雑にすると表現力が上がり,かえって訓練データに合わせ込みやすくなるので過学習を悪化させる。エは汎化性能こそが未知データへの当てはまりの良さであり,これを下げるのは過学習そのものである。記述の後半「より多くの未知のデータに対して予測できるように」と前半が矛盾している。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問3
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問192.リアルタイム性が求められる組込みシステムにおいて,システムへの入力に対するリアルタイムな応答の方法として,最も適切なものはどれか。
- ア.OS を使用しないで応答する。
- イ.定められた制限時間内に応答する。
- ウ.入力された順序を守って応答する。
- エ.入力時刻を記録して応答する。
正解:イ.定められた制限時間内に応答する。
解説:リアルタイムシステムの「リアルタイム」は「速い」ことではなく,「決められた制限時間(デッドライン)内に必ず処理を終える」ことを指す。応答が正しくてもデッドラインを過ぎれば失敗とみなすのがリアルタイム性の定義であり,答はイ。デッドラインを1度でも破ると致命的になるものをハードリアルタイム(自動車の制動制御,航空機の姿勢制御など),多少の遅れが許されるものをソフトリアルタイム(動画再生など)と呼び分ける。アは,リアルタイム OS(RTOS)を使えば優先度に基づくスケジューリングや割込み応答時間の保証が得られるので,OS を使わないことがリアルタイム性の条件ではない。実際,多くの組込みシステムは RTOS 上で時間制約を満たしている。ウの到着順の処理はむしろリアルタイム性を損なうことがあり,締切の近い処理を先に実行する方式(EDF)や優先度の高い処理を先に実行する方式が使われる。エの入力時刻の記録は事後の分析やタイムスタンプの用途であって,応答が時間内に終わることを保証する仕組みではない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問4
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問193.A,B,C の順序で入力されるデータがある。各データについてスタックへの挿入と取出しを1回ずつ行うことができる場合,データの出力順序は何通りあるか。
- ア.3
- イ.4
- ウ.5
- エ.6
正解:ウ.5
解説:スタックは後入れ先出しなので,出力できる順序は挿入と取出しの組合せで決まる。実際に列挙すると,A挿入→A取出→B挿入→B取出→C挿入→C取出で A B C,A挿入→A取出→B挿入→C挿入→C取出→B取出で A C B,A挿入→B挿入→B取出→A取出→C挿入→C取出で B A C,A挿入→B挿入→B取出→C挿入→C取出→A取出で B C A,A挿入→B挿入→C挿入→C取出→B取出→A取出で C B A の5通りになる。したがって答はウ。C A B だけは作れない。C を最初に出すには A と B が C より下に積まれている必要があり,そのとき A は B より下にあるので,次に出るのは必ず B になるからである。一般に n 個のデータで作れる出力順序の数はカタラン数 (2n)!/(n!(n+1)!) で与えられ,n=3 では 6!/(3!×4!)=720/144=5 となって列挙結果と一致する。エの6は 3!=6,つまり並べ方すべてが可能だと考えた場合の値で,C A B が作れない点を見落としている。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問5
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問194.図の2分探索木に1と0の二つの要素を順に追加した AVL 木として,適切なものはどれか。
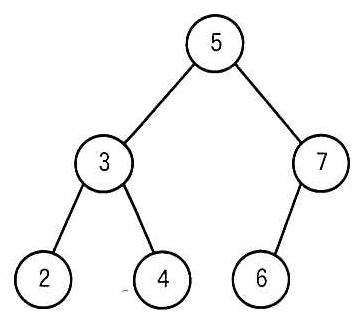
- ア.
- イ.
- ウ.
- エ.
正解:ウ.
解説:AVL 木は,どの節でも左部分木と右部分木の高さの差が1以下になるように保つ2分探索木である。まず1を追加すると,2分探索木の規則に従って 2 の左の子になる。このとき 2 の左は高さ1・右は無し(高さ0)で差は1,3 の左部分木は高さ2・右部分木(4)は高さ1で差は1,根の 5 も左が高さ3・右(7と6)が高さ2で差は1なので,どこも崩れておらず回転は不要である。続いて0を追加すると 1 の左の子になり,節 2 の左部分木の高さが2,右部分木が0となって差が2になり,左の左に偏った形(LL型)で崩れる。この場合は 2 を右に1回転させ,1 を親,0 を左の子,2 を右の子にする。その結果,根から 5,左の子が 3,3 の左が 1(子は0と2),3 の右が 4,5 の右が 7,7 の左が 6 という形になり,これに一致するのはウである。エは 5 の右部分木が 6 を親として 7 を子とする形になっており,追加した要素は左側だけなので右部分木が変化する理由がない。アは根が 3,イは根が 4 で,どちらも根まで作り替えており,1回の LL 型の回転で済むところを木全体の再構築とみなしている点が誤りである。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問6
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問195.fact(n)は,非負の整数 n に対して n の階乗を返す。fact(n)の再帰的な定義はどれか。
- ア.if n=0 then return 0 else return n×fact(n−1)
- イ.if n=0 then return 0 else return n×fact(n+1)
- ウ.if n=0 then return 1 else return n×fact(n−1)
- エ.if n=0 then return 1 else return n×fact(n+1)
正解:ウ.if n=0 then return 1 else return n×fact(n−1)
解説:再帰的な定義が正しく働くには,再帰を止める基底の値と,引数が確実に基底へ近づく再帰呼出しの二つがそろっている必要がある。階乗は 0!=1 と定義され,n!=n×(n−1)! が成り立つので,n=0 のとき 1 を返し,そうでなければ n×fact(n−1) を返すウが正しい。アとイは基底で 0 を返している。すると n×fact(n−1) の連鎖の末端が0になるため,fact(1)=1×fact(0)=0,fact(2)=2×0=0 のように,どんな n でも結果が0になってしまう。イとエは再帰呼出しが fact(n+1) で引数が増える方向なので基底の n=0 に到達せず,呼出しが止まらないまま再帰が深くなってスタックがあふれる。したがって基底が1で引数が減るウだけが階乗を返す。実際に fact(3) をたどると 3×fact(2)=3×(2×fact(1))=3×2×(1×fact(0))=3×2×1×1=6 となり,3!=6 に一致する。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問7
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問196.同じ命令セットをもつコンピュータ A と B とがある。それぞれの CPU クロック周期,及びあるプログラムを実行したときの CPI(Cycles Per Instruction)は,表のとおりである。そのプログラムを実行したとき,コンピュータ A の処理時間は,コンピュータ B の処理時間の何倍になるか。 〔表〕 コンピュータ A:CPU クロック周期 1ナノ秒/CPI 4.0 コンピュータ B:CPU クロック周期 4ナノ秒/CPI 0.5
- ア.1/32
- イ.1/2
- ウ.2
- エ.8
正解:ウ.2
解説:命令セットが同じなので,同じプログラムなら実行する命令数も同じになる。1命令当たりの時間は「CPU クロック周期×CPI」で求められるから,コンピュータ A は 1ナノ秒×4.0=4ナノ秒,コンピュータ B は 4ナノ秒×0.5=2ナノ秒である。処理時間は命令数に比例するので,比は 4÷2=2 となり,A は B の2倍の時間が掛かる。答はウ。クロック周期はコンピュータ A のほうが4分の1と短く一見速そうだが,1命令に4サイクル掛けるため,1命令を0.5サイクルで実行できるコンピュータ B に負けている。クロック周波数だけで性能を比べられないことを示す問題である。エの8は 4.0÷0.5 で CPI の比だけを取り,クロック周期の違いを無視した値。イの 1/2 は正しい比の逆を取ったもので,B が A の何倍かに当たる。アの 1/32 は,掛け合わせる相手を取り違えて (1×0.5)÷(4×4)=0.5÷16 と計算した場合の値である。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問8
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問197.DMA コントローラーの説明として,適切なものはどれか。
- ア.MPU では時間が掛かる積和演算を,高速に行う。
- イ.仮想メモリ機能,メモリ保護機能などのメモリ管理機能を提供する。
- ウ.動作クロックに合わせてカウントするカウントレジスタをもち,それによって時間の経過を保持する。
- エ.メモリと入出力装置,又はメモリとメモリとの間のデータ転送を,MPU を介さずに行う。
正解:エ.メモリと入出力装置,又はメモリとメモリとの間のデータ転送を,MPU を介さずに行う。
解説:DMA(Direct Memory Access)は,メモリと入出力装置の間などのデータ転送を CPU(MPU)を通さずに行う仕組みで,これを制御する専用回路が DMA コントローラーである。CPU は転送元アドレス・転送先アドレス・転送量を設定して起動するだけでよく,転送中は別の処理を進められるので,大量のデータを扱うディスクや通信の入出力で処理効率が大きく上がる。したがって答はエ。アの積和演算を高速に行うのは DSP(ディジタルシグナルプロセッサ)や積和演算器の説明で,信号処理や機械学習の演算で使われる。イの仮想メモリやメモリ保護を担うのは MMU(メモリ管理ユニット)で,論理アドレスを物理アドレスへ変換し,許可されていない領域へのアクセスを検出する。ウの動作クロックを数えて時間の経過を保持するのはタイマ(カウンタ)で,一定周期の割込み発生や経過時間の測定に用いる。いずれも DMA コントローラーとは役割が異なる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問9
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問198.オブジェクトストレージの特徴として,適切なものはどれか。
- ア.オブジェクトにはユニークな識別子が割り当てられ,識別子を使ってアクセスする。
- イ.オブジェクトの内容を更新する際,上書き更新をする。
- ウ.広域分散を実現するためには,遠隔地のストレージと静止点を設けて同期を行う必要がある。
- エ.ストレージはディレクトリの概念を使った階層構造である。
正解:ア.オブジェクトにはユニークな識別子が割り当てられ,識別子を使ってアクセスする。
解説:オブジェクトストレージは,データを「オブジェクト」という単位で,データ本体・メタデータ・一意の識別子(オブジェクト ID や キー)の組として格納する方式である。利用者はディレクトリをたどるのではなく,識別子を指定して直接読み書きするので,答はア。この方式は保存先の物理的な位置に縛られず,台数を増やすだけで容量と性能を伸ばせるため,クラウドの大容量ストレージや,画像・ログ・バックアップの保管に広く使われている。イは,オブジェクトストレージは一部だけを書き換える上書き更新を行わず,オブジェクト全体を新しいものに置き換えるのが基本であり(イミュータブル),これがバージョン管理や改ざん検知と相性がよい理由でもある。ウは,広域分散では複数拠点へ非同期に複製し,時間が経てば同じ内容に収束する結果整合性を前提とするのが一般的で,静止点を設けて同期を取る必要はない。エは,オブジェクトストレージの名前空間は階層をもたないフラットな構造で,ディレクトリの階層構造をもつのはファイルストレージである。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問10
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問199.マルチプロセッサによる並列処理で得られる高速化率(単一プロセッサのときと比べた倍率)E を,次の式によって評価する。r=0.9 のアプリケーションの高速化率が r=0.3 のものの3倍となるのは,プロセッサが何台のときか。 E=1/(1-r+r/n) ここで, n:プロセッサの台数(1≦n) r:対象とする処理のうち,並列化が可能な部分の割合(0≦r≦1) とし,並列化に伴うオーバーヘッドは考慮しないものとする。
- ア.3
- イ.4
- ウ.5
- エ.6
正解:エ.6
解説:式に値を入れると,r=0.9 のときの高速化率は 1/(0.1+0.9/n),r=0.3 のときは 1/(0.7+0.3/n) である。前者が後者の3倍になる条件は 1/(0.1+0.9/n)=3/(0.7+0.3/n) で,たすきに掛けると 0.7+0.3/n=3×(0.1+0.9/n)=0.3+2.7/n となる。整理して 0.4=2.4/n,すなわち n=6 が得られるので答はエ。検算すると,n=6 のとき r=0.9 では 1/(0.1+0.15)=1/0.25=4倍,r=0.3 では 1/(0.7+0.05)=1/0.75=1.333…倍で,4÷1.333…=3 とちょうど3倍になる。この式はアムダールの法則で,台数 n をいくら増やしても高速化率は 1/(1-r) が上限になる。r=0.9 なら10倍,r=0.3 なら約1.43倍が限界で,並列化できる割合が性能を決めることが分かる。台数を増やすと二つの高速化率の比は 2.0倍(n=3),約2.4倍(n=4),約2.7倍(n=5)と少しずつ増えていくので,アからウはいずれも3倍に届いていない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問11
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問200.二つのシステム A,B の稼働率をそれぞれ α_A(0<α_A<1),α_B(0<α_B<1),MTBF をそれぞれ MTBF_A,MTBF_B,MTTR をそれぞれ MTTR_A,MTTR_B としたとき,これらの関係として,常に成り立つものはどれか。
- ア.α_A=α_B ならば,MTBF_A=MTBF_B であり,かつ MTTR_A=MTTR_B である。
- イ.α_A=α_B ならば,MTTR_A/MTBF_A=MTTR_B/MTBF_B である。
- ウ.α_A>α_B ならば,MTBF_A>MTBF_B であり,かつ MTTR_A>MTTR_B である。
- エ.α_A>α_B ならば,MTTR_A/MTBF_A>MTTR_B/MTBF_B である。
正解:イ.α_A=α_B ならば,MTTR_A/MTBF_A=MTTR_B/MTBF_B である。
解説:稼働率は α=MTBF/(MTBF+MTTR) で定義される。分子と分母を MTBF で割ると α=1/(1+MTTR/MTBF) と書けるので,稼働率は MTTR/MTBF という比だけで決まり,しかもこの比が大きいほど稼働率は小さくなる(単調に減少する)。したがって α_A=α_B であることと MTTR_A/MTBF_A=MTTR_B/MTBF_B であることは同じ意味になり,イは常に成り立つ。アは,たとえば MTBF=100時間・MTTR=1時間のシステムと MTBF=200時間・MTTR=2時間のシステムはどちらも稼働率 100/101=200/202 で等しいが,MTBF も MTTR も等しくないので成り立たない。ウは,稼働率が高いほうが MTBF も MTTR も大きいとは限らない。上の例の MTBF が長いほうを MTTR=3時間にすれば,MTBF は大きいのに稼働率は下がる。エは向きが逆で,α_A>α_B なら比は小さいほうが A なので MTTR_A/MTBF_A<MTTR_B/MTBF_B となる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問12
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問201.図のように3個の装置を並列と直列に組み合わせて構成したシステムがある。装置単体の稼働率と,システムの稼働率の関係を示したグラフはどれか。ここで,3個の装置の稼働率は,全て等しいものとする。
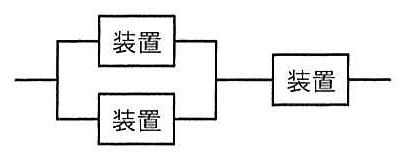
- ア.
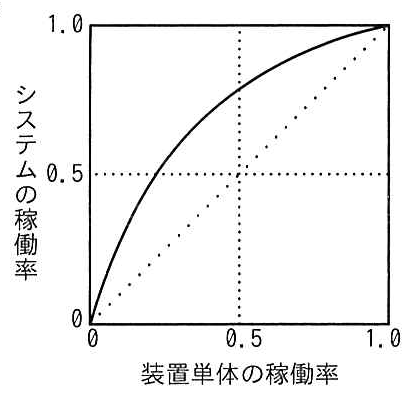
- イ.
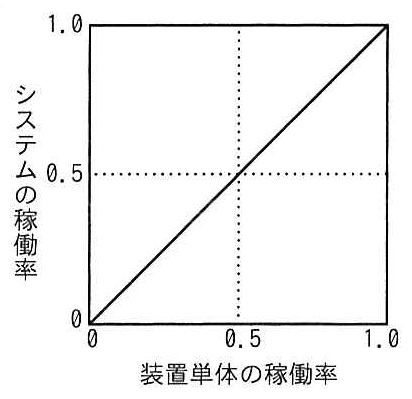
- ウ.
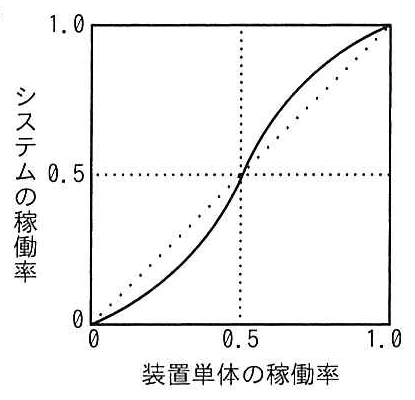
- エ.
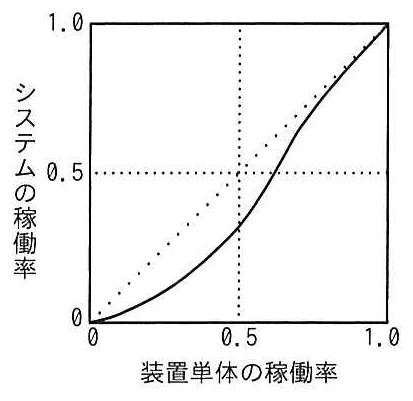
正解:エ.
解説:装置単体の稼働率を a とする。並列部分は2台のどちらかが動いていればよいので,稼働率は 1-(1-a)²=2a-a² になる。システム全体はこの並列部分と残り1台の直列なので,(2a-a²)×a=2a²-a³ となる。この値を単体の稼働率 a と比べると,2a²-a³-a=-a(a-1)² となり,0<a<1 では常に負である。つまりシステムの稼働率は必ず装置単体より低く,グラフは対角線(点線)より下側だけを通り,両端の0と1でだけ対角線に接する。実際 a=0.5 では 2×0.25-0.125=0.375 で,対角線の0.5より下になる。この形に合うのはエ。直列がある以上,並列で冗長にしても単体を上回れないことを示している。アは対角線より上にあり,これは並列2台だけの 2a-a²(a=0.5 で0.75)の形で,直列の1台を考えていない。イは対角線そのもので,装置1台のときの関係。ウは a=0.5 でちょうど0.5となって対角線と交わっており,これは3台の多数決(2 out of 3)の 3a²-2a³(a=0.5 で0.5)の形で,この構成とは異なる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問13
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 - ア.
-
問202.リアルタイム OS において,実行中のタスクがプリエンプションによって遷移する状態はどれか。
- ア.休止状態
- イ.実行可能状態
- ウ.終了状態
- エ.待ち状態
正解:イ.実行可能状態
解説:プリエンプションとは,実行中のタスクからOSが強制的にCPUを取り上げ,より優先度の高いタスクに渡すことをいう。取り上げられたタスクは処理を続けられる状態のままなので,CPUさえ割り当てられればすぐ動ける「実行可能状態(レディ)」に移り,順番が来れば実行状態に戻る。したがって答はイ。タスクの状態遷移は,生成されて実行可能状態に入り,OSのディスパッチで実行状態になり,入出力の完了待ちやイベント待ちで自ら待ち状態に移り,待っていた事象が起きると実行可能状態へ戻る,という流れが基本である。アの休止状態は,まだ生成されていない,あるいは終了して資源が残っている段階で,実行中のタスクが割込みだけでここへ移ることはない。ウの終了状態は自らの処理を終えたときに入る状態で,プリエンプションは処理を打ち切らないので該当しない。エの待ち状態は,タスク自身が入出力要求や資源待ちなど「事象が起きるまで動けない」ときに入る状態であり,プリエンプションのようにOSの都合でCPUを譲る場合とは区別される。この違いは,待ち状態のタスクは事象が起きるまで実行可能にならないのに対し,プリエンプションされたタスクはすぐ実行可能である点にある。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問14
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問203.仮想記憶管理におけるページ置換えアルゴリズムとして LRU 方式を採用する。主記憶のページ枠が,4000,5000,6000,7000番地(いずれも16進数)の4ページ分で,プログラムが参照するページ番号の順が,1→2→3→4→2→5→3→1→6→5→4のとき,最後の参照ページ4は何番地にページインされているか。ここで,最初の1→2→3→4の参照で,それぞれのページは4000,5000,6000,7000番地にページインされるものとする。
- ア.4000
- イ.5000
- ウ.6000
- エ.7000
正解:ウ.6000
解説:LRU は「最も長い間参照されていないページ」を追い出す方式なので,参照のたびに新しさの順を更新して追う。最初の1→2→3→4で 4000番地=ページ1,5000番地=ページ2,6000番地=ページ3,7000番地=ページ4 となり,古い順は 1,2,3,4 である。次の参照2はヒットで古い順は 1,3,4,2。参照5は不在なので最も古いページ1を追い出し,5が4000番地に入る(古い順は 3,4,2,5)。参照3はヒットで 4,2,5,3。参照1は不在なので最も古いページ4のある7000番地を使い(古い順は 2,5,3,1),参照6は不在なので最も古いページ2のある5000番地を使う(古い順は 5,3,1,6)。参照5はヒットで 3,1,6,5 となり,最後の参照4は不在なので最も古いページ3が置かれている6000番地に入る。したがって答はウ。アの4000番地はこの時点でページ5,イの5000番地はページ6,エの7000番地はページ1が入っており,いずれも4より後に参照されているので追い出されない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問15
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問204.表は,OSS のライセンスごとに,そのライセンスの OSS を利用したプログラムを配布するとき,ソースコードを公開しなければならないかどうかを示す。a〜d に入れるライセンスの適切な組合せはどれか。ここで,表中の“○”は公開しなければならないことを表し,“×”は公開しなくてもよいことを表す。 〔表〕OSS ライセンス a/b/c/d OSS のソースコードを修正して作ったプログラム:○/○/○/× OSS に静的にリンクしたプログラム:○/○/×/× OSS に動的にリンクしたプログラム:○/×/×/×
- ア.a:GPL,b:LGPL,c:MPL,d:BSD
- イ.a:GPL,b:MPL,c:BSD,d:LGPL
- ウ.a:LGPL,b:GPL,c:MPL,d:BSD
- エ.a:LGPL,b:MPL,c:BSD,d:GPL
正解:ア.a:GPL,b:LGPL,c:MPL,d:BSD
解説:表は左から右へ公開義務が緩くなる並びになっているので,コピーレフトの強さの順にライセンスを当てはめればよい。a は修正・静的リンク・動的リンクのすべてで公開が必要な最も強いもので,これは GPL である。GPL は,リンクした部分も含めて全体を派生物とみなし,同じ条件で公開することを求める。b は動的リンクだけ公開が不要で,これはライブラリ向けに GPL を緩めた LGPL に当たる。LGPL は,ライブラリを差し替えられる形(動的リンク)で使う限り,利用側のプログラムを公開しなくてよい。c は修正した場合だけ公開が必要で,これはファイル単位のコピーレフトを採る MPL である。MPL は修正したファイルのソース公開を求めるが,別ファイルとして書いた自分のコードには及ばない。d はどの場合も公開が不要で,これは著作権表示と免責条項の保持だけを条件とする BSD ライセンスである。したがって a=GPL,b=LGPL,c=MPL,d=BSD となり,答はア。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問16
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問205.OpenAPI Specification に従った API の定義・開発を支援する機能を提供する OSS はどれか。
- ア.curl
- イ.OpenAM
- ウ.Serverspec
- エ.Swagger
正解:エ.Swagger
解説:OpenAPI Specification は,REST API の入出力やエンドポイントの仕様を YAML や JSON で機械可読に記述するための標準仕様である。この仕様に沿って API を定義し,仕様書の閲覧・テスト実行・クライアントやサーバのひな形コード生成までを支援する OSS が Swagger(Swagger Editor,Swagger UI,Swagger Codegen などの総称)で,答はエ。もともと Swagger という名前で作られた仕様が寄贈されて OpenAPI Specification となった経緯があり,両者は密接に関係している。アの curl は,コマンドラインから HTTP をはじめとする各種プロトコルでデータを送受信するツールで,API の呼出し確認には使えるが,仕様を定義する機能はもたない。イの OpenAM は,シングルサインオンやアクセス管理を提供する認証基盤の OSS である。ウの Serverspec は,サーバに導入されたパッケージやサービスの状態が意図どおりかを RSpec の記法でテストするツールで,インフラの構成管理の検証に使われる。いずれも API 仕様の記述を支援するものではない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問17
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問206.8ビット D/A 変換器を使って負でない電圧を発生させる。使用する D/A 変換器は,最下位の1ビットの変化で出力が10ミリV変化する。データに0を与えたときの出力は0ミリVである。データに16進数で82を与えたときの出力は何ミリVか。
- ア.820
- イ.1,024
- ウ.1,300
- エ.1,312
正解:ウ.1,300
解説:D/A 変換器の出力は「与えたデータの値×1ビット当たりの電圧」で決まる。データ0で0ミリVと決まっているので,オフセットを考える必要はない。16進数の82を10進数に直すと 8×16+2=130 であり,1ビット当たり10ミリVだから 130×10=1,300ミリV になる。したがって答はウ。なお8ビットなので与えられるデータは0〜255(16進数で00〜FF)の256段階,出力の範囲は0〜2,550ミリVであり,1,300ミリVはその範囲に収まっている。アの820は,16進数の82を10進数の82とみなして 82×10 と計算した値で,基数の変換を忘れた場合に当たる。エの1,312は 82×16=1,312 に一致する値で,「16進数」を「16倍する」と取り違えた場合に出る。イの1,024は 2¹⁰ に当たる値で,8ビットという条件から桁数を取り違えたときに選びやすいが,130段階×10ミリVというこの設問の条件からは導けない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問18
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問207.産業機器の制御装置として使われる PLC の説明として,適切なものはどれか。
- ア.自動制御であり,偏差の比例,積分及び微分の3要素で制御する。
- イ.主としてラダー図を用いたシーケンスプログラムによって制御する。
- ウ.電圧及び電流のアナログ信号をデジタル信号に変換する。
- エ.リレーシーケンス回路のハードウェアによって制御する。
正解:イ.主としてラダー図を用いたシーケンスプログラムによって制御する。
解説:PLC(Programmable Logic Controller)は,工場の生産設備などで順序制御を行うための専用コントローラで,入力(センサやスイッチ)の状態に応じて出力(モータやバルブ)を決める手順をプログラムとして書き込み,繰り返し実行する。プログラムの記述には,リレー回路の図面をそのままなぞったラダー図が主に使われるので,答はイ。ラダー図は電気技術者が読み書きしやすく,配線変更なしに制御内容をソフトで書き換えられる点が PLC の利点である。アは偏差の比例・積分・微分で操作量を決める PID 制御の説明で,温度や流量のように連続量を目標値に近づける制御方式であり,順序制御を主とする PLC の定義ではない。ウはアナログ信号をデジタル信号に変換する A/D 変換器の説明で,PLC のアナログ入力ユニットに組み込まれることはあるが,PLC そのものの説明ではない。エはリレーシーケンス回路の説明で,これは PLC が普及する前に使われていた,接点とコイルの配線で論理を組む方式である。配線を組み替えないと動作を変えられない点が,プログラムで変更できる PLC との決定的な違いである。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問19
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問208.FPGA などに実装するデジタル回路を記述し,論理合成するために使用される言語はどれか。
- ア.DDL
- イ.HDL
- ウ.UML
- エ.XML
正解:イ.HDL
解説:HDL(Hardware Description Language:ハードウェア記述言語)は,デジタル回路の構造や動作を文章で記述するための言語で,代表的なものに VHDL と Verilog HDL がある。記述した内容を論理合成ツールに掛けると,論理ゲートやフリップフロップの組合せ(ネットリスト)に変換され,FPGA や ASIC に実装できる形になる。したがって答はイ。回路図を引く代わりにプログラムのように書けるため,大規模な回路でも設計・修正・検証がしやすく,シミュレーションによる動作確認も同じ記述で行える。アの DDL(Data Definition Language)は,データベースの表やインデックスの定義に使う SQL の一分類で,CREATE や ALTER などがこれに当たる。ウの UML(Unified Modeling Language)は,クラス図やシーケンス図などでソフトウェアの構造や振る舞いを表す統一モデリング言語である。エの XML(Extensible Markup Language)は,タグで意味を示しながらデータを構造化して記述するための汎用のマークアップ言語で,設定ファイルやデータ交換に広く使われる。いずれも回路を論理合成する用途のものではない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問20
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問209.IoT システムにおいて,センサーの値をゲートウェイに送信するセンサーノードの消費電流を抑えるため,図のような間欠動作を考える。センサーノードの動作時間は10ミリ秒で,その間は平均して 10mA の電流が流れる。待機中は常に 0.1μA の電流が流れる。間欠動作の平均電流を 1μA 以下にするための待機時間として,最も短いものはどれか。ここで,平均電流の値を求める時間は十分に長いものとする。
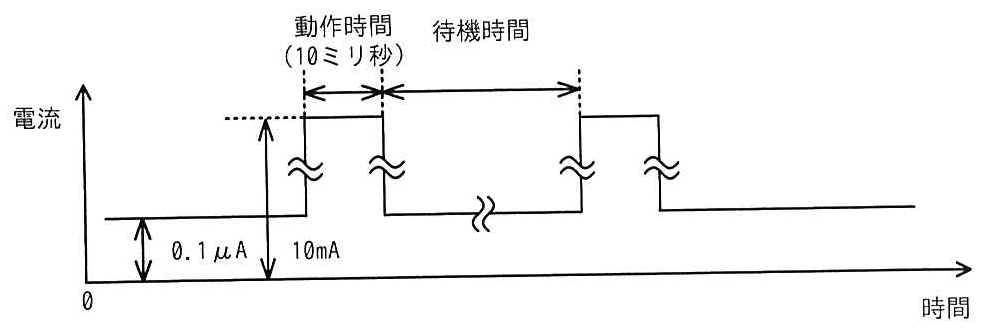
- ア.1.1秒
- イ.11.1秒
- ウ.111.1秒
- エ.1111.1秒
正解:ウ.111.1秒
解説:平均電流は「1周期に流れた電気量÷周期の長さ」で求める。単位をそろえて,動作時間 0.01秒・電流 10,000μA,待機時間 t 秒・電流 0.1μA とすると,1周期の電気量は 10,000×0.01+0.1×t=100+0.1t(μA・秒),周期は 0.01+t 秒である。平均電流が1μA以下という条件は (100+0.1t)/(0.01+t)≦1 で,分母を払うと 100+0.1t≦0.01+t,整理して 99.99≦0.9t となり t≧111.1秒が得られる。したがって最も短い待機時間は111.1秒でウ。検算すると,t=111.1 のとき電気量は 100+11.11=111.11,周期は 0.01+111.1=111.11 で,平均電流はちょうど 1μA になる。動作中の電流が待機中の10万倍もあるため,10ミリ秒動かすだけで待機約111秒分の電気を使ってしまう,というのがこの計算の意味である。エの1111.1秒は10倍長く,条件は満たすが「最も短いもの」ではない。イの11.1秒では平均電流が (100+1.11)/11.11≒9.1μA,アの1.1秒では (100+0.11)/1.11≒90μA となり,どちらも1μAを大きく超える。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問21
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問210.ユーザーインタフェースのユーザビリティを評価する手法には,利用者が参加するものと専門家だけで実施するものとがある。利用者が参加する手法と専門家だけで実施する手法との適切な組合せはどれか。
- ア.利用者が参加する手法:アンケート/専門家だけで実施する手法:回顧法
- イ.利用者が参加する手法:回顧法/専門家だけで実施する手法:思考発話法
- ウ.利用者が参加する手法:思考発話法/専門家だけで実施する手法:ヒューリスティック評価法
- エ.利用者が参加する手法:認知的ウォークスルー法/専門家だけで実施する手法:ヒューリスティック評価法
正解:ウ.利用者が参加する手法:思考発話法/専門家だけで実施する手法:ヒューリスティック評価法
解説:ユーザビリティ評価の手法は,実際の利用者に操作してもらう「ユーザーテスト系」と,専門家が知識に基づいて画面を点検する「専門家評価系」に分かれる。思考発話法は,利用者にタスクを行ってもらいながら考えていることを声に出させ,どこでつまずいたかを把握する方法で,利用者が参加する手法である。ヒューリスティック評価法は,ヤコブ・ニールセンらがまとめた経験則(ヒューリスティックス)に照らして,専門家が画面を点検し問題点を洗い出す方法で,利用者は参加しない。この組合せに合うのはウ。アの回顧法は,利用者に操作してもらった後で「あのときどう考えたか」を振り返って語ってもらう方法なので利用者が参加する手法であり,専門家だけで実施する側に置くのは誤り。イも同じ理由で回顧法の位置は正しいが,思考発話法を専門家側に置いている点が誤りである。エの認知的ウォークスルー法は,専門家が初めての利用者になったつもりで操作手順を1段階ずつたどり,学習しやすさを評価する方法で,専門家だけで実施する手法に当たるため,利用者が参加する側に置くのは誤りである。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問22
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問211.W3C で仕様が定義され,矩形や円,直線,文字列などの図形オブジェクトを XML 形式で記述し,Web ページでの図形描画にも使うことができる画像フォーマットはどれか。
- ア.OpenGL
- イ.PNG
- ウ.SVG
- エ.TIFF
正解:ウ.SVG
解説:SVG(Scalable Vector Graphics)は,W3C が仕様を定めたベクター画像のフォーマットで,矩形・円・直線・曲線・文字列といった図形を XML のタグで記述する。座標や大きさを数値でもつため,拡大・縮小しても輪郭がぼやけず,テキストなのでスタイルシートやスクリプトから操作でき,Web ページに直接埋め込んで描画できる。したがって答はウ。アの OpenGL は,2次元・3次元のグラフィックスを描画するための API(関数群)の仕様であって,画像ファイルの形式ではない。イの PNG は可逆圧縮のラスター(点の集まり)画像形式で,透明度を扱えて Web で広く使われるが,図形を XML で記述するものではなく,拡大すると粗くなる。エの TIFF も同じくラスター画像形式で,複数ページや高階調を扱えることから印刷やスキャナの分野で使われるが,XML 記述でも W3C の仕様でもない。ラスターとベクターの違い,そして「XML で書かれている」という点が SVG を見分ける手掛かりになる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問23
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問212.大量の IoT デバイスから送信される大量で,かつ様々な形式のデータを格納可能なデータモデルのうち,行ごとに任意の列数をもち,かつ列ごとに複数の値をもつことによって,柔軟なデータ格納を実現しているデータモデルはどれか。
- ア.グラフ
- イ.ドキュメント
- ウ.リレーショナル
- エ.ワイドカラム
正解:エ.ワイドカラム
解説:ワイドカラム指向(列指向)データモデルは,行ごとに異なる列をもてる構造で,あらかじめ全体の表構造を決めておく必要がない。関連する列をまとめたカラムファミリという単位をもち,1つの列に複数の値(タイムスタンプ付きの複数バージョンなど)を保持できるため,種類の異なるセンサーデータが大量に届く IoT の用途に向く。設問の「行ごとに任意の列数」「列ごとに複数の値」という説明にそのまま当てはまるので答はエで,代表的な製品に Apache Cassandra や HBase がある。アのグラフモデルは,データを節(ノード)と関係(エッジ)で表し,つながりをたどる検索を得意とするもので,人間関係や経路の分析に使われる。イのドキュメントモデルは,JSON や XML のような入れ子構造の文書を1件ずつ格納する方式で,構造の自由度は高いが「行と列」という枠組みでは説明されない。ウのリレーショナルモデルは,あらかじめ定めた列の並び(スキーマ)に従って全ての行が同じ列をもつ表の形であり,行ごとに列数が変わることも1つの列に複数の値を入れることも原則として認められない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問24
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問213.UML を用いて表した図のデータモデルを関係データベース上に実装する際の解釈のうち,適切なものはどれか。
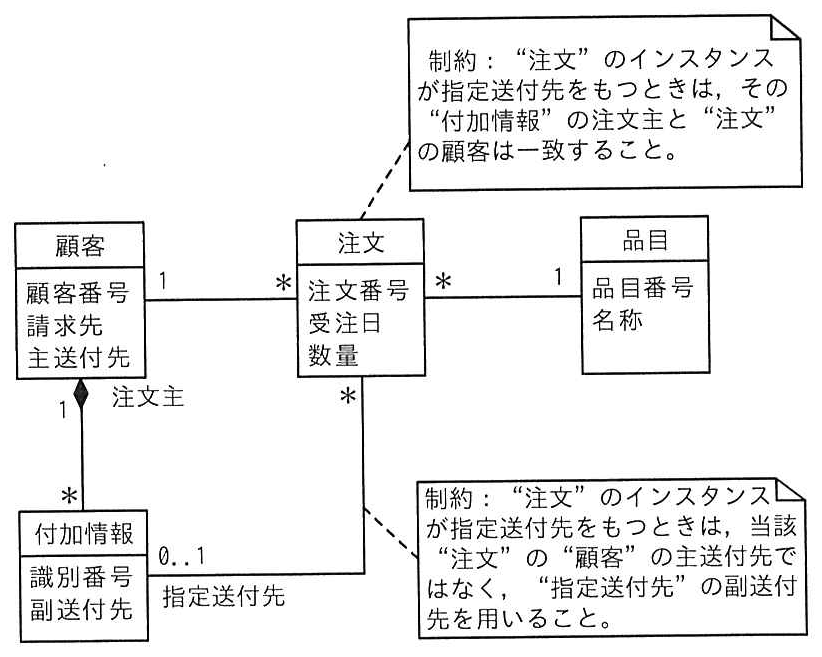
- ア.“指定送付先”を指定する際,“付加情報”表のどの行でも選択できる。
- イ.“付加情報”表と“顧客”表の行数は一致していなければならない。
- ウ.“付加情報”表には“顧客”表に対する参照制約を指定する。
- エ.“付加情報”表には“注文”表に対する参照制約を指定する。
正解:ウ.“付加情報”表には“顧客”表に対する参照制約を指定する。
解説:図では“顧客”と“付加情報”が「1対多(注文主)」で結ばれており,付加情報の側が「どの顧客のものか」を必ずもつ。関係データベースでは,1対多の多側に1側の主キーを外部キーとしてもたせるので,“付加情報”表に“顧客”表の顧客番号を参照する参照制約(外部キー制約)を指定することになる。したがって答はウ。エは向きが逆である。“注文”と“付加情報”は「多対0..1(指定送付先)」なので,多側である“注文”表のほうに“付加情報”表を参照する外部キーをもたせる。0..1 は「指定送付先をもたない注文もある」という意味で,その場合この外部キーは空値になる。アは,図に添えられた制約に「“注文”のインスタンスが指定送付先をもつときは,その“付加情報”の注文主と“注文”の顧客は一致すること」と書かれているので,他人の付加情報を指定送付先にはできない。選べるのはその注文の顧客に結び付いた行だけである。イは,顧客と付加情報の多重度が1対多(多側は0個でもよい)なので,付加情報を1件ももたない顧客も,複数もつ顧客も存在してよく,行数が一致する必然性はない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問25
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問214.システムをバージョンアップするとき,システムの稼働環境を二つ用意しておき,一方の環境で現バージョンのシステムを稼働させた状態のままで他方の環境のシステムをバージョンアップし,ロードバランサーなどを使って稼働環境を切り替える。これによって,切替えに伴うシステムのダウンタイムを短くするとともに,バージョンアップしたシステムで不具合が発生したときには,元のバージョンに切り戻す時間を短くすることができる。この手法を何というか。
- ア.ブルーグリーンデプロイメント
- イ.ホットスタンバイ
- ウ.ホットスワップ
- エ.ローリングアップデート
正解:ア.ブルーグリーンデプロイメント
解説:ブルーグリーンデプロイメントは,同等の稼働環境を2組(慣習的にブルーとグリーンと呼ぶ)用意し,片方で現行版を動かしたまま,もう片方に新版を配置して十分に確認したうえで,ロードバランサーなどで振り向け先を一気に切り替える手法である。切替えは経路の変更だけなので停止時間が短く,不具合が出たときは振り向け先を元に戻すだけで切り戻せる。したがって答はア。イのホットスタンバイは,待機系を常に起動しておき,現用系が故障したら引き継ぐ可用性の確保策で,バージョンアップの手順ではない。ウのホットスワップは,電源を入れたまま機器の部品(ディスクや電源ユニットなど)を交換できる仕組みで,ハードウェアの保守に関する用語である。エのローリングアップデートは,複数のサーバを何台かずつ順番に新版へ入れ替えていく方式で,環境を2組用意する必要はない代わりに,入替えの途中で新旧の版が同時に動く期間が生じる。切戻しも入れ替えた台数分をやり直すことになり,一気に切り替える方式とは性質が異なる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問46
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問215.ソフトウェアの保守性を定量評価するときに使用する指標として,適切なものはどれか。
- ア.(運用期間中に発生した不具合件数)÷(プログラムの規模)
- イ.(適正規模の基準を満たすプログラムの数)÷(プログラムの総数)
- ウ.(テスト実施済みの分岐の数)÷(プログラムの総分岐数)
- エ.(プログラムの推定総エラー数)-(摘出エラー数)
正解:イ.(適正規模の基準を満たすプログラムの数)÷(プログラムの総数)
解説:保守性とは「修正のしやすさ」であり,理解しやすさ・変更しやすさ・試験しやすさに支えられる。1本のプログラムが大きくなるほど,どこを直せばよいかの把握に時間が掛かり,修正の影響も読みにくくなるので,モジュールの大きさを適正な範囲に保っているかどうかは保守性を測る直接の手掛かりになる。適正規模の基準を満たすプログラムの数を全体の数で割ったイが,その割合を示す指標であり,答はイ。アは,運用中に出た不具合の件数を規模で割った不具合密度で,作られたものがどれだけ正しく動くかを表す信頼性の指標である。エの推定総エラー数から摘出済みのエラー数を引いた値は,まだ見つかっていない残存エラーの推定数で,これも信頼性に関する指標にあたる。ウはテスト済みの分岐を総分岐数で割った分岐網羅率で,テストがどこまで行き届いたかを示すテストの十分性の指標である。いずれもソフトウェアの品質を測る指標ではあるが,測っている品質の側面が保守性とは異なる。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問47
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問216.XP(Extreme Programming)のプラクティスの一つであるものはどれか。
- ア.構造化プログラミング
- イ.コンポーネント指向プログラミング
- ウ.ビジュアルプログラミング
- エ.ペアプログラミング
正解:エ.ペアプログラミング
解説:XP は,短い反復で開発を進めるアジャイル開発手法の一つで,実践すべき具体的な行動をプラクティスとしてまとめている。代表的なものに,2人1組で1台の端末に向かい一方が書きもう一方が確認するペアプログラミング,先にテストを書いてから実装するテスト駆動開発,動作を変えずに内部構造を整えるリファクタリング,こまめに統合して常に動く状態を保つ継続的インテグレーション,コードを全員の共有物とする共同所有などがある。したがって答はエ。アの構造化プログラミングは,順次・選択・繰返しの3つの制御構造だけでプログラムを構成するという古典的な設計原則で,特定の開発手法のプラクティスではない。イのコンポーネント指向プログラミングは,再利用可能な部品を組み合わせてシステムを作る考え方である。ウのビジュアルプログラミングは,図形要素を画面上で組み合わせて処理を記述する方式で,教育用の環境などで使われる。いずれもプログラミングの様式や手段を指す言葉であって,XP が掲げるプラクティスには含まれない。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問48
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。 -
問217.分散システムの脆弱性を実験によって発見する手法であるカオスエンジニアリングには,五つの原則がある。この原則のうちの三つは,“定常状態における振る舞いの仮説を立てる”,“実世界の事象を多様化させる”,“継続的に実行できるよう実験を自動化する”である。あと二つの原則の組みはどれか。
- ア.“開発環境で実験を行う”,“影響範囲を局所化する”
- イ.“開発環境で実験を行う”,“影響範囲を広く捉える”
- ウ.“本番環境で実験を行う”,“影響範囲を局所化する”
- エ.“本番環境で実験を行う”,“影響範囲を広く捉える”
正解:ウ.“本番環境で実験を行う”,“影響範囲を局所化する”
解説:カオスエンジニアリングは,稼働中の分散システムにあえて障害を注入し,どこまで耐えられるかを実験で確かめて弱点を先に見つける手法である。原則は5つあり,設問に挙げられた3つのほかに「本番環境で実験を実行する」と「影響範囲を局所化する(爆発半径を最小限にする)」がある。したがって答はウ。本番環境で行うのは,実際の利用者の負荷や構成の組合せは試験環境では再現しきれず,そこにこそ未知の弱点が潜むからである。ただし本番で行う以上,利用者への被害を最小限に抑えなければならないので,対象をごく一部に絞り,異常を検知したら直ちに実験を中止できる仕組みを備えたうえで進める。この2つは「実際の環境で試す」と「それでも被害は小さく抑える」という一見相反する要求を両立させる組合せになっている。アとイの「開発環境で実験を行う」は,本番でしか現れない条件を扱えないため原則に反する。イとエの「影響範囲を広く捉える」は被害を広げる方向であり,局所化するという原則と逆である。
出典:情報処理推進機構「令和7年度春期 応用情報技術者試験 午前問題」問49
本試験の問題です。出題当時の法令・制度にもとづいているため、その後の改正で現在の扱いと異なる場合があります。